Agent 状态与因果恢复
以 PD-KVC、ASJ、Durable Write 和分层快照连接执行与恢复
解释会话 KV、逻辑状态和外部效果的不同恢复要求,展开 AT 四字段、持久提交、故障窗口、有序协调与会话熔断,并连接开放集群的管理能力。
长时Agent任务同时保留三种状态:模型继续推理所需的KV,任务推进所需的上下文、工具结果和依赖关系,以及已经产生的外部效果。三者的容量、更新频率和恢复条件不同。基础设施需要让状态位置、因果提交与会话控制相互关联,才能在暂停、迁移和故障后继续推进任务。OCP的Agentic Fabric白皮书将这一需求组织为PD-KVC、Agent State Journaling和面向会话的Fabric扩展。S045 pp. 7–22, 29–30
从单次模型调用扩展到可恢复任务#
训练恢复通常加载模型与优化器checkpoint,并重新执行丢失的计算;Agent执行中还可能已经修改代码、调用API或写入数据库。恢复点因此需要知道哪个动作已完成、产生什么结果、下一个动作依赖什么信息。模型状态和任务因果历史必须能够对应,外部副作用还需要工具后端参与确认。S044 pp. 40, 43 S045 pp. 17–22
多Agent进一步增加共享与协调状态。Planner分派子任务后,executor、verifier与critic可能共享同一前缀,却各自增长私有上下文;任务完成、结果报告和取消又改变全局依赖。调度器仅看GPU空闲量会漏掉状态回迁和协调成本,运行时仅保留文本历史则难以直接利用已计算的KV。S045据此将共享内存与持久执行日志纳入同一个架构。S045 pp. 8–16, 26–30
原图可从上向下追踪一次任务:A2A连接planner和子Agent,MCP连接工具,PD-KVC保存共享推理状态,最下方ASJ记录动作历史。重点看共享KV与journal两条路径:前者服务后续计算,后者决定恢复时如何解释已发生的动作。
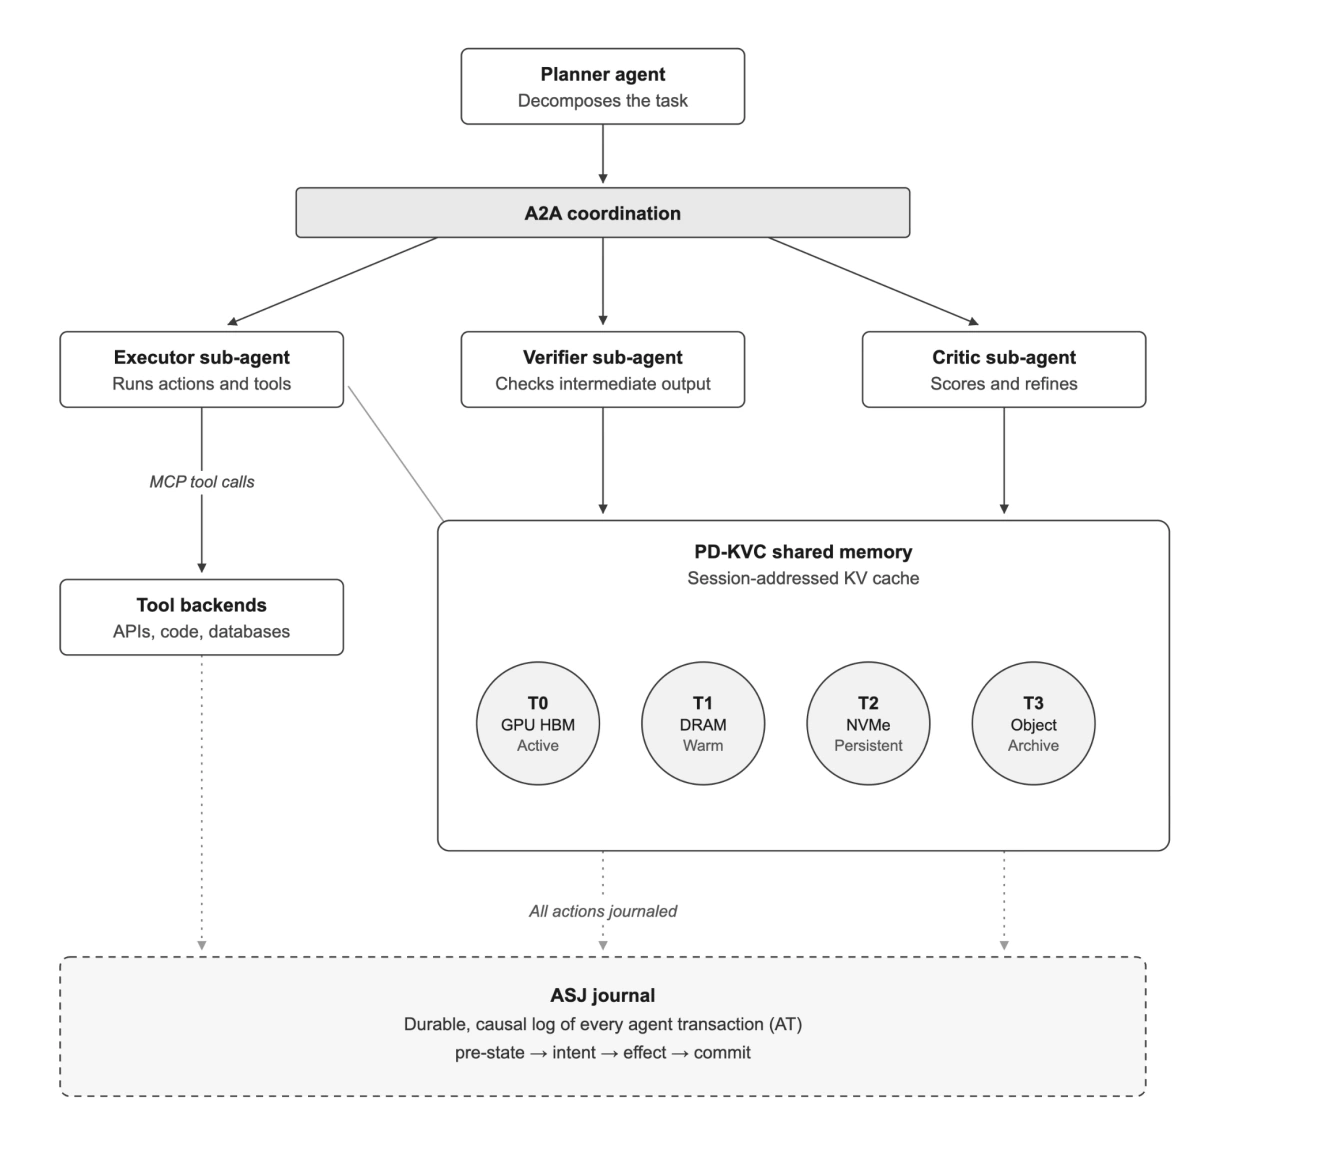
原图:S045,物理第5页,Figure 1,OCP AI HW/SW Co-Design Workgroup,CC BY-SA 4.0。
会话寻址让KV具有可管理的生命周期#
PD-KVC提案以 寻址缓存,允许按层和token区间读取。缓存还绑定模型、精度与kernel上下文,避免不同配置的条目被混用。共享前缀采用内容哈希寻址与去重,会话私有部分保留在自己的命名空间;权限和QoS归属仍可追到具体会话。S045 pp. 12–14
状态层级分别为T0活跃HBM、T1 RDMA DRAM暖池、T2 NVMe持久层和T3对象归档。当前推理步骤运行前,所需KV应先驻留T0;会话进入工具等待或暂停后,可以将状态转移到T1/T2释放HBM。预测下一步会话的预取引擎,利用当前任务执行窗口准备其工作集。分层机制由此连接到调度,而所需带宽取决于迁移量与可用预载时间。S045 pp. 11–16
共享前缀带来引用计数要求。一个planner前缀被三个子Agent引用时,结束其中一个会话只释放它自己的引用;仍有活跃引用的共享块继续保留。每个会话的active、suspended、completed状态决定私有KV的驱逐策略,共享块再受全体引用约束。这个设计把前缀复用、租户隔离与内存回收连接起来;实际GPU执行仍需获得本地工作集。S045 pp. 13–14
Agent Transaction记录进展的四个部分#
ASJ把一次Agent进展表达为Agent Transaction,包含pre-state、intent、effect和commit。Pre-state保存动作前的逻辑状态与内存引用;intent记录工具调用或子Agent生成等动作及参数;effect保存实际结果、外部效果和完成状态;commit在effect持久化确认后写入。恢复时,从已提交边界结合后续记录判断已完成、在途和未开始动作。S045 pp. 19–20
这要求传输确认与持久确认具有不同语义。普通RDMA Write completion只提供相应远端传输完成语义;S045提出Durable Write,要求journal节点确认数据已进入约定持久化域。其实现涉及NIC/DPU、交换路径和NVMe后端协同,确认点接近存储的fsync或commit。对于ASJ,每次写入是KB到MB量级的小记录,关注点转为持续IOPS和尾部提交时延。S045 pp. 20–22, 29–30
一个写代码并提交结果的任务可以这样重建其恢复状态。动作前保存工作区与上下文引用,intent标明目标仓库、操作参数和动作ID;操作完成后,effect保存返回结果和实际提交标识;effect达到持久化条件后,commit允许推进后续步骤。这是本文对AT字段的具体应用示例,实际接口还需确定intent何时持久化、哪些状态随快照保存,以及外部工具怎样按动作ID查询结果。S045 pp. 19–22
外部副作用决定恢复协议的最后一段#
最关键的故障窗口位于外部效果已经生效、effect尚未提交之间。此时日志可能只知道动作已发出,恢复者需要从工具后端确认结果,或利用幂等键避免重复,或执行定义好的补偿。S045将高价值非幂等动作的轻量两阶段协同列为后续研究,并指出AT schema与部分失败语义需要形式化。S045 p. 22
工程实现可以据此建立三类恢复路径:能够按动作ID查询结果的工具,先查询再补记effect;接受幂等键的工具,按相同键恢复执行;有补偿协议的工具,根据已观察效果决定补偿或继续。这是本文提出的实现分类,具体工具能力应成为runtime适配器的契约。将恢复决策留在可审计的runtime层,再由fabric提供可靠传输、隔离与持久确认,能够保持各层职责明确。S045 pp. 18–22
ASJ正文建议journal写与工具执行并行,以隐藏写入开销;可靠实现仍要明确并发时序和失败边界。Intent、工具效果、effect持久化与commit的先后关系,应以协议状态机固化,并测试每个间隙发生进程退出、网络分区或存储失败时的行为。S045尚把协议形式化与生产写延迟测量列为开放工作,这两项也适合作为原型验收的优先目标。S045 pp. 20–22
全量快照与细粒度日志控制恢复时间#
Hierarchical Agent Checkpointing将周期性完整快照与ASJ结合。完整快照可包含KV、逻辑内存引用、工具历史和环境状态,写入T2;两个快照之间由AT日志保存细粒度进展。恢复时加载最近快照,再重建之后的已提交动作,快照间隔因而决定日志回放上限。S045 pp. 20–21
设本文示例每分钟完成60个AT,每十分钟做一次完整快照,恢复最多需要处理约600个AT的日志。提高快照频率可以减少回放工作,同时增加持续写入和KV快照流量。系统需要把恢复目标转成快照窗口、journal IOPS与状态恢复带宽,并在多个会话同时恢复时检查共享路径。训练checkpoint偏大块并行写的能力可以复用,Agent还需要更频繁的持续状态服务。S044 pp. 40–44 S045 pp. 20–22
有序协调、小消息与大块状态共同进入QoS#
Agent Coordination Channel提案为任务分配、结果和控制消息提供可靠有序的小消息通道,并与ASJ连接以恢复多Agent协调状态。消息量小,顺序和持久性却直接影响任务是否重复分派或遗漏结果。S045同时指出,记录为AT的协调消息具有持久写开销;紧急控制可以先走低时延传输,持久审计路径再按runtime协议处理。S045 pp. 26–27
这些消息会与bulk KV、快照和TP collective共享部分链路。Fabric需要区分低时延小消息、持久journal和高吞吐状态搬移,防止恢复流量抬高控制尾时延。现有推理RA列出TC0、TC3和TC6等平台类别,ACC与Durable Write则是Agent白皮书提出的进一步语义。实施时可以复用分类与遥测机制,再增加会话归属、journal确认和runtime动作接口。S047 pp. 57–59 S045 pp. 14–15, 20, 26–30
将恢复时间和提交语义同时纳入测试#
恢复测试需要观察两个结果:任务是否在目标时间内继续,以及继续后的动作历史是否正确。本文建议从AT四个字段建立故障矩阵,在intent写入、工具执行、effect写入和commit之间分别注入失败,检查恢复者能够取得哪些信息、接下来调用哪个工具接口。外部后端是否接受动作ID、是否允许结果查询和补偿,应在同一测试记录中明确。这样,持久写时延和恢复正确性可以在相同协议版本下评估。S045 pp. 19–22
状态层故障还会改变恢复路径。T0 worker退出后,会话可能从T1恢复KV;暖池不可用时,转向T2快照或token日志重算;journal节点故障则要求按约定durability判断哪些AT已提交。每条恢复路径需要自己的容量和时延预算,且要与其他会话同时恢复的共享负载一起测量。S045的层级内存、HAC和JournalNode模型给出了表达这些条件的对象。S045 pp. 12–16, 20–22, 29–30
多Agent恢复还要核对任务分配与结果的因果顺序。Planner恢复后,需要知道哪个子任务已分派、哪个结果已接受、哪些后续任务可以启动;子Agent恢复自己的上下文,也要保持与planner已提交协调状态一致。ACC与ASJ的结合正是为这类状态重建提供记录基础。本文建议使用同一session/task/AT关联键贯通协调消息、KV引用和工具动作,让失败演练能够从一条日志追到完整依赖。S045 pp. 26–30
让会话控制进入可解释的运行模型#
S045的熔断提案综合三类信号:资源预算、上层语义异常和工具后端watchdog。触发后封锁新调用,处理当前步骤,flush并seal日志,再向编排器报告。语义判断由上层监控提供,NIC与交换机按会话标签执行限流或封锁;预期效果是隔离具体任务,并保留可恢复的因果记录。S045 pp. 21–22
InfraGraph相应增加MemoryTierNode、session affinity、AgentTaskGraph、JournalNode和CircuitBreakerEdge。它们把缓存驻留、上下文增长、工具频率、写入P99与动作策略放到同一个可查询模型中。结合XOC的scheduler、monitoring与独立OoB,系统可以把一次任务的慢步骤追到KV迁移、日志提交或设备故障,而后采取对应动作。S045 pp. 29–30 S050 pp. 11–14, 48–51
Agent基础设施的规划单位由此扩展为“带状态与提交历史的会话”。计算资源、状态池、journal和连接入口分别扩容,依赖关系由runtime与调度器共同维护。KV容量与迁移的展开见推理解耦与KV数据路径,层级介质、持久写和数据服务的配置见存储层级与数据服务。
