拓扑放置与端到端性能建模
从首跳域和通信矩阵到硬件图、执行 trace 与状态亲和
用首跳域、同 rail 比例和跨域字节解释局部性,将 GPU/NIC 内部路径、workload DAG 与会话状态位置结合,建立可校准的放置优化方法。
集群的可用性能取决于工作负载如何占据拓扑。相同的服务器、NIC 和交换容量,将同一并行组放在一个首跳域或分散到多个域,会改变 spine 流量、拥塞位置和同步等待。拓扑选择与调度策略需要共同设计:硬件提供哪些局部通信机会,调度器就应把这些机会转成可分配的资源边界。S048 pp. 22–25 S044 pp. 51–55
首跳域把通信局部性变成调度对象#
单归属 Clos 将每台八xPU服务器的八条后端NIC接到同一leaf。在DS5000的64×400G下行基线下,一个leaf服务八台服务器,组成64xPU首跳域。只要通信两端都在这八台服务器内,域内后端流量便留在该leaf;跨rail交互也具有相同局部性。调度器把四台服务器的任务放进一个这样的域,就可以把它的节点间后端通信集中在首跳交换机内。S048 pp. 20–23
rail-optimized 将同一GPU/NIC亲和索引放到共同leaf。64服务器、八rail的单平面实例有八台leaf,每台接一个rail的64个NIC;同rail通信在整个64服务器域中保持leaf-local,跨不同rail leaf的通信则进入spine。32服务器构型每台leaf接两个rail,16服务器构型每台接四rail。因而域大小与跨rail局部性形成可调权衡。S048 pp. 24–25, 30–35
这些边界适合直接进入资源描述。节点可携带首跳域、rail域和plane标签,调度器按并行组与通信方式选择节点集合。OPG是管理和组合单元,首跳域是由实际布线决定的性能单元;二者可以重合,也可以由一个OPG内部划出多个局部域。规划需要将对应关系写进资产和调度数据,而后通过流量验证。S048 pp. 23–26, 51–54
以通信矩阵衡量局部性收益#
只看作业占用几台服务器,无法比较两种接线。本文用一个简化计量式表示进入spine的字节量:设作业后端总流量为 ,同rail流量占比为 ;同rail与跨rail流量各有 、 的比例能在leaf内完成,则:
这个表达式是对RA局部性规则的重建,忽略多跳重复计量和网络封装。单归属首跳域内,;跨域分散后,两项都可能下降。单rail一leaf的完整rail域里,,跨不同rail leaf的部分 。它把同rail占比和实际放置位置分开,使比较条件可以复算。S048 pp. 23–25, 35–37
例如,本文假设一个32节点训练作业总后端数据量100GB,其中90%是同rail交换。若全部放进一个足够大的rail域,同rail90GB留在leaf,跨rail最多约10GB进入spine;若将相应rank散到多个rail域,同rail流量也需上行,收益随放置破坏而消失。相同作业若由大量跨rail路由主导,单归属的域内通信可能更合适,但32节点又超过单个八节点域,需要继续计算跨域的实际通信比例。拓扑选择应由rank通信矩阵和分配方式共同确定。S048 pp. 24–25, 36–37
MoE尤其需要动态矩阵。AFPM指出EP的通信随token到专家的选择变化,因此“同rail占比”可能随模型阶段、batch和输入改变。训练中的梯度同步、推理中的专家分发和KV迁移也可能共享上行。规划时可以按操作阶段分别采样通信矩阵,再将重叠窗口叠加到真实路径,观察哪一个阶段形成持续热点。S044 pp. 14–15, 52–55
硬件图必须深入服务器内部#
NIC的rail亲和性来自服务器内部PCIe路径。GPU与特定NIC之间有较短的连接路径,跨CPU、跨PCIe交换层的访问代价会不同。因此,硬件模型至少需要描述GPU、CPU、NIC、内存及内部连接,再把NIC端点接到集群leaf。只保留“服务器之间400G”的模型,无法表达rank选错NIC或GPU到NIC路径变化带来的成本。S048 p. 30 S044 pp. 47–49
InfraGraph原图左侧是设备与组件构成的实际关系,右侧把它们分成可复用的device定义和基础设施实例。阅读时重点看两层均保留links与edges:模型既要知道某类连接具有什么属性,也要知道本次部署中哪两个端点真正相连。
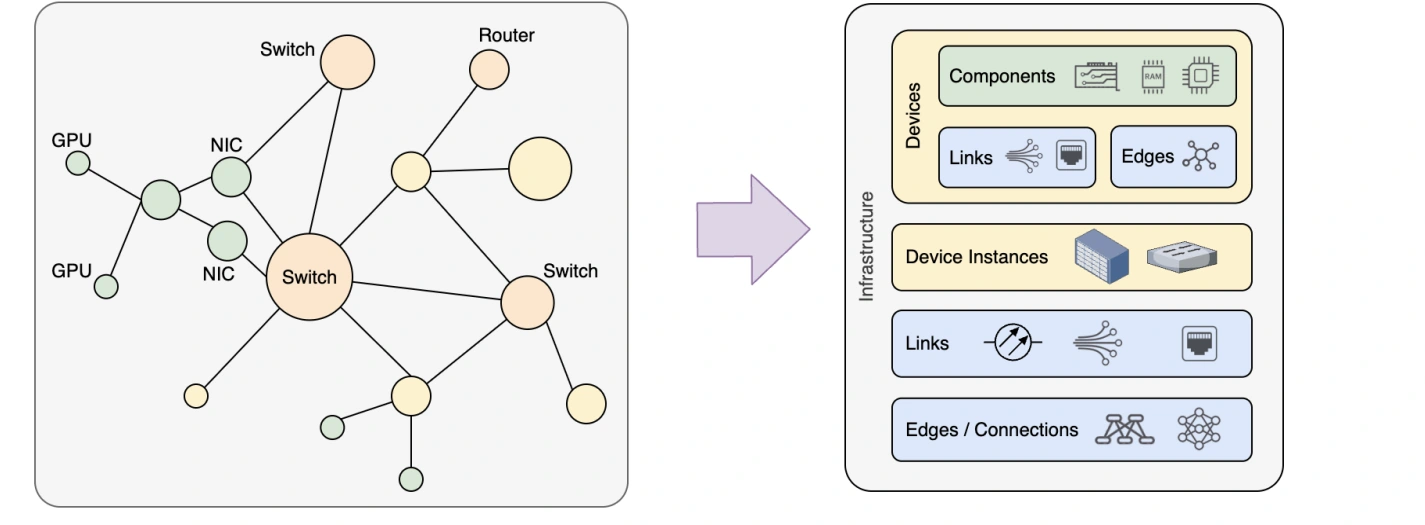
原图:S044,物理第48页,Figure 4,OCP AI HW/SW Co-Design Workgroup,CC BY-SA 4.0。
InfraGraph的link描述连接类型,edge表示具体连接,device可作为嵌套子图复用。带宽、平均与尾时延、功率和可靠性等annotation可以附着在同一底图。OPG/XOC的connectivity map则提供实例端点和端口号。把二者对齐,就能让设计模型、施工清单与运行遥测使用可追踪的连接坐标。S044 pp. 45–50 S049 pp. 16–18
用依赖图识别真正暴露的通信时间#
硬件图需要与workload DAG相配合。AFPM以Chakra执行trace举例:节点描述计算量、张量、内存访问或collective,边描述操作依赖。映射决策引擎同时满足拓扑、显存和共置约束,优化端到端执行时间。总网络字节数相同的两种放置,如果其中一种允许数据预取与当前计算重叠,完成时间仍可能不同。S044 pp. 52–55
作为本文算例,假设一个会话有10GB KV工作集,下一步开始前可预取120ms,回迁有效单向带宽50GB/s。单纯串行化下界为200ms,至少还有80ms无法被窗口覆盖;若会话被安排在更近的状态池、有效带宽升到100GB/s,下界缩到100ms,便有机会把传输隐藏在窗口里。实际还需加入排队、存储读取和控制开销。算例说明状态位置与时间窗口应进入放置目标,相关机制在S045的阶段预载设计中明确提出。S045 pp. 13–16
训练同样如此。DP归约可与部分计算重叠,但参数更新存在最终同步依赖;PP下游要等待activation;TP每层结果要及时可用。调度优化应该优先缩短暴露在这些依赖上的通信,并用trace验证其与计算重叠的程度。对各种依赖的展开见并行策略塑造通信关键路径。S044 pp. 35–37, 43–44
在局部性、资源碎片和共享干扰之间取舍#
一个首跳域能否装下作业,还取决于可分配资源的形状。本文假设八节点域里已有一个四节点任务和两个单节点任务,剩余两节点;另一个域空闲四节点。新来的四节点任务可以在第二个域保持完整局部性,直接选择全局最空闲GPU却可能将它分散到两处。把域作为分配对象后,空闲卡数与能完整容纳的作业数可以分别统计,避免资源碎片被总量掩盖。S048 pp. 23–25, 37
较大的rail域容纳多种任务大小更灵活,但局部性收益仍受通信类型约束。多个租户可以共同使用同一rail域,只要相应同rail伙伴仍在该域,同rail流就保持首跳局部性;租户数增加则可能在同一leaf上形成新的并发竞争。因此调度器既需要域内优先,也需要观察共享交换资源和状态池的实际负载。RA把域大小、同rail占比和任务打包装填一起讨论,提供了这种联合选择的依据。S048 pp. 24–25, 36–37
放置目标可以分为硬约束和成本。显存、设备数量、可达性、租户边界与collective所需排列必须满足;在可行方案中,再比较作业完成时间、跨域流量、数据迁移和对已有任务的干扰。AFPM的映射引擎明确需要同时考虑本地HBM、远程池、拓扑限制和共置规则。本文据此建议保留候选方案的分项成本,让“更优放置”能解释为缩短了哪段等待、增加了多少搬移。S044 pp. 52–55
状态亲和还会使放置随时间改变。一个会话刚开始时可以选择prefill最空闲的节点,进入多轮执行后KV已经驻留,后续步骤更适合优先考虑状态附近的计算资源。若为了短期GPU均衡迁走会话,新增迁移成本和其他会话争用可能抵消收益;若长期固定,又可能留下负载不均衡。S045的AgentTaskGraph提供后续步骤、上下文增长和工具调用频率,能够让放置决策利用会话未来需求。S045 pp. 13–16, 29–30
建模精度可以按决策需要逐层增加。先用链路容量和拓扑判断哪些候选方案不可行,再加入有效带宽与依赖窗口比较明显差异,最后对接近的候选引入排队与并发trace。实测时保留同一硬件、固件、任务形状和数据量的条件,模型预测与测量差异则回到相应组件参数修正。这样,昂贵的仿真集中在会改变选择的部分,日常调度仍可以使用已校准的层级规则。S044 pp. 49–55 S048 pp. 52–55
将仿真搜索接到安全的运行反馈#
AFPM提出三类映射方式。仿真搜索逐个估计候选放置,适合深入比较特定模型与硬件组合;学习方法从计算图和设备特征预测分配,需要足够训练数据并处理跨工作负载泛化;混合方法先按TP/DP等知识划分网络层级,再在域内搜索。极大规模和动态多租户增加组合复杂度,因此分层与增量优化尤为关键。S044 pp. 53–55
运行验证可以从一个可控变更开始:固定作业、数据、并行参数与host配置,只改变节点是否落在共同首跳域,比较spine利用率、p95/p99和作业时长。训练RA把这类前后对照列进验证计划,并要求检查调度标签是否真的符合端口映射。VLAB适合核验配置与故障流程,物理网络上的流量、buffer行为和NIC性能则由实际负载测量补齐。S048 pp. 52–55
Agent场景还要更新状态坐标。S045建议MemoryTierNode记录各层容量与尾时延,session affinity记录当前KV位置,AgentTaskGraph提供后续步骤和上下文增长预测。一个调度动作可能同时改变GPU位置、状态回迁和日志写入路径,因此收益评估要把迁移成本计入。InfraGraph与在线数字孪生提供了组织这些信息的研究框架,实际系统可先从可解释的域内优先、会话亲和和受控canary开始建立反馈。S045 pp. 29–30 S044 pp. 50–55
拓扑规划由此可以形成连续闭环:连接图定义可达路径,trace定义通信依赖,放置决定实际负载,遥测校准预测,下一次分配再利用校准结果。端口预算见从Pod组到开放集群,会话状态和恢复路径见Agent状态与因果恢复。
