存储层级与分布式数据服务
供数、KV 驻留、checkpoint 与 journal 的资源和确认语义
将 OPG 存储接入、主动数据服务和 T0–T3 会话层级交叉展开,分别计算容量、迁移与恢复预算,并区分大块 checkpoint 和小记录持久提交。
AI集群中的存储需要同时服务计算供数、状态驻留和故障恢复。训练数据与checkpoint关注并行吞吐,embedding查询可能直接进入计算关键路径,推理KV随会话活跃程度在不同介质间迁移,Agent journal则要求明确的持久提交。将这些对象按访问方式和生命周期分层,再映射到NIC、交换网络与控制服务,才能把存储容量转成可使用的系统能力。S044 pp. 37–44 S045 pp. 8–22
从数据仓库转为主动数据服务#
AFPM将distributed data services与计算通信放在同一系统中,涵盖训练集并行读取、近端缓存、embedding后备存储、checkpoint、数据变换、压缩和安全。数据服务的任务是以适当时序把计算所需对象送到消费位置,并维持对象版本、访问权限和恢复能力。设备与协议由此需要围绕端到端操作配置。S044 pp. 37–42
例如,训练数据可以在当前batch计算时预取,embedding lookup却可能要求当前计算等待返回。Checkpoint可以把快照状态在后台写出,系统仍需确定该版本何时达到约定的可恢复条件。网络规划因此要同时记录平均消费速率、峰值写入、并发恢复和暴露在依赖上的访问时延。AFPM分别讨论同步时延敏感与可异步重叠的I/O,提供了按操作分类的基础。S044 pp. 40–44
GPUDirect Storage与RDMA可让兼容路径直接在存储和GPU内存间传输,减少CPU数据搬移和内核路径开销。数据变换、压缩、加密和纠删码等服务也可借助近存储计算或DPU/SmartNIC卸载。效果依赖对象格式、数据路径和所用软件;若预处理扩大数据,变换位置还会改变网络字节量。规划应将变换前后大小与消耗资源一起计入数据图。S044 pp. 38–42
OPG存储构件提供可核算的接入预算#
早期OPG-128包含十六台xPU-node、五台数据存储服务器和两台metadata server。每台xPU-node有2×100G存储连接,每台数据服务器有4×400G,每台metadata server有2×400G;存储leaf连接这些端点,并通过详细图和接线表所示的32×400G上行接到共享层。S052 pp. 14–16, 36–39
按这一配置复算,计算节点侧合计3.2Tb/s,即400GB/s线速字节带宽;数据服务器NIC合计8Tb/s,即1TB/s;metadata接入合计1.6Tb/s;上行12.8Tb/s。几个方向的容量不同:本地计算节点读取会先受到其接入与存储服务能力约束,跨OPG共享与head-end流则还消耗上行。评估时应沿实际读写路径检查每段资源,并加入介质、CPU和协议的有效性能。S052 pp. 36–39
每台存储服务器的24个NVMe槽使五台合计120槽,与128颗xPU规模接近;原设计用“约一块PCIe5 NVMe/xPU”作资源估计。后续项目应按数据集大小、checkpoint体积、复用缓存和介质耐久度确定实际配置。Metadata请求与bulk transfer又走不同服务角色,增加磁盘数量时需要同步观察元数据CPU和请求尾部。S052 pp. 12, 15–16, 53–55
XOC共享层还连接client和staging服务,使外部数据准备能够先进入受控入口,再送入计算存储域。镜像、容器、代码仓库及CI/CD有各自的管理存储与分发路径。把这些控制资产与训练数据分开描述,能让作业恢复、节点重装和应用版本回滚各自找到可用的源。S050 pp. 10–14, 42–49
KV的四层架构按会话活跃度分配昂贵内存#
KV与模型权重具有不同增长方式:权重由模型结构确定,KV随上下文长度、活跃请求与注意力表示变化。长期把暂停会话留在HBM会消耗服务并发容量;每次从token历史重做prefill又增加计算。S045提出T0活跃HBM、T1 RDMA DRAM暖池、T2 NVMe持久层、T3对象归档,将活跃步骤、近期上下文、完整会话和长期记忆分别配置。S045 pp. 8–12
下面原表的关键列是Latency Target与Contents。T1指向近期步骤和共享上下文,T2承接完整会话与快照,T3进入归档。表内数值是该提案的架构目标:T1域内1–10μs、跨域5–20μs,T2读10–100μs、持续写50–200μs;它们为不同访问路径提出不同设计要求。
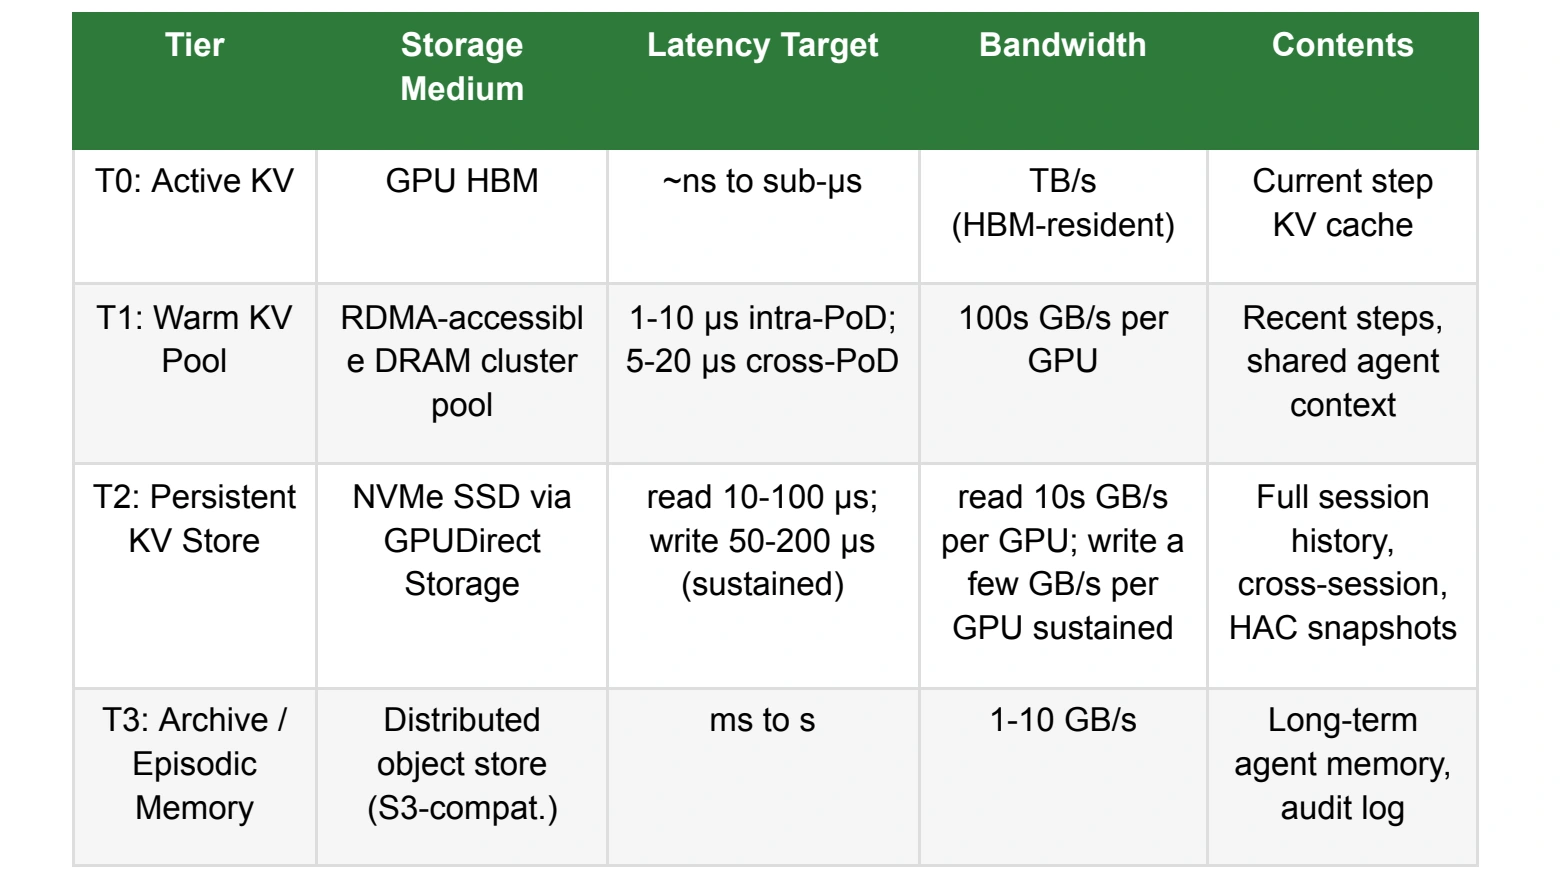
原表:S045,物理第12页,Table 1,OCP AI HW/SW Co-Design Workgroup,CC BY-SA 4.0;数值属性为架构目标。
T0工作集应在decode启动前准备就绪。T1/T2服务主要发生在会话切换、恢复和子Agent交接时,调度器利用后续步骤预测进行预载。S045还讨论远程attention与缓存压缩的协同设计,具体实现需要保留读取粒度、kernel约束和传输预算。阶段预载路径可以先建立清晰的开始、完成与消费时刻,便于测量隐藏了多少迁移时间。S045 pp. 13–16
容量命中与迁移代价一起决定缓存价值#
PD-KVC的地址包括session、layer和token range,并在固定模型、精度与kernel上下文内使用。共享前缀内容寻址,私有后缀会话隔离;共享块按引用计数回收,私有条目按active、suspended和completed状态驱逐。这个生命周期可以把频繁恢复的会话留在暖池,长暂停会话下沉到NVMe,完成会话再归档。S045 pp. 13–14
缓存保留策略还要比较transfer与recompute。Token日志远小于产生的KV,长时间暂停后重新prefill可能比从较慢层回迁更合适。本文可用 表示恢复成本,再与prefill重算时间、可用预取窗口比较。缓存命中率提高是否改善请求时延,取决于命中位置和数据能否及时到达。S045 p. 16
恢复突发会把容量问题转成共享出口问题。本文假设一个暖池承接100个各10GB的会话,容量需求为1TB;若其中20个会话需在2秒内同时恢复,至少要提供100GB/s有效总读取,接收端和共享网络也要承接相同数据。顺序恢复与并发恢复具有相同总容量,却有不同的带宽和队列尾部要求。InfraGraph的MemoryTierNode因此需要容量、带宽、平均与尾时延和驱逐策略等属性。S045 pp. 29–30
大块checkpoint与小记录持久提交分别设计#
训练checkpoint包含模型、优化器等状态,适合由多个rank并行写入大体积数据;快速恢复要求反向并行读回。副本或纠删码提供介质与节点故障下的durability和availability,具体保护机制会增加空间与写入成本。AFPM把这些RAS能力与存储吞吐共同列为数据服务的核心要求。S044 pp. 40–41
Agent的ASJ写入则是KB到MB级AT记录,每步effect持久化确认后才能commit。S045提出Durable Write,要求持久存储确认与RDMA传输完成分开表达;高耐久NVMe journal pool关注持续IOPS和P99。系统因此可能需要同时服务bulk snapshot与低时延journal,分别设置调度和可观测指标。S045 pp. 19–22, 29–30
Hierarchical Agent Checkpointing在两者之间建立关系:完整快照限制日志回放长度,ASJ记录快照之间的细粒度因果进展,KV经PD-KVC写入T2。完整恢复需要同时取得逻辑状态、KV或重算材料、已提交日志和工具结果。相关故障窗口与协议选择见Agent状态与因果恢复。S045 pp. 20–22
按并发事件规划数据服务的有效能力#
数据服务容量可以分成稳定消费和事件突发。稳定消费来自每个训练副本的数据预取、持续decode状态和日常journal;事件突发来自checkpoint、模型上线、批量会话恢复和节点重装。两类负载的重叠关系决定池出口、CPU、元数据和网络的余量。AFPM要求fabric同时满足compute-to-compute和compute-to-storage的聚合负载,这种分解可以将需求转成明确的并发场景。S044 pp. 41–44
作为本文算例,假设一项作业每十分钟生成1TB checkpoint,平均写入速率约1.67GB/s;若要求二十秒内完成写出,窗口内有效带宽至少50GB/s。两个作业同时写出,存储和共享网络需求就叠加到100GB/s。平均速率用于长期写入与介质寿命规划,完成窗口用于峰值容量和队列调度,两者分别保留才能解释为什么平均空闲的服务仍会拖慢快照。S044 pp. 40, 43–44
Metadata和小记录服务需要独立负载描述。大量小文件、缓存区间查询或AT提交可能以请求率和P99先达到上限,大块顺序吞吐却仍有剩余。OPG把metadata server和storage server分成角色,Agent模型进一步把JournalNode的IOPS、写延迟与durability作为原生属性。本文据此建议为各对象分别建立访问大小分布、并发和完成条件,再选择介质与服务实例。S052 pp. 15–16, 53–55 S045 pp. 29–30
控制资产在恢复风暴中同样重要。更换节点可能同时读取OS镜像、容器层、模型权重和checkpoint;这些对象分布于head-end仓库、staging和训练存储域。XOC为仓库与构建服务保留专门接口,带内路径用于配置和软件分发,高流量生产数据使用相应高速网络。恢复计划按对象安排并发和优先级,可以让管理服务保持响应,并让计算节点按批次回到可调度状态。S050 pp. 10–14, 48–49
分层控制让数据服务可扩展也可恢复#
存储管理至少有三个相互关联的层次。介质与数据服务维护副本、对象、元数据和持久确认;网络控制维护连接、VRF、路径与队列;集群调度维护作业、会话、状态位置和资源分配。OPG/XOC提供物理与服务角色,训练RA用Wiring/VPC意图管理网络,Agent提案再通过session affinity把动态状态位置反馈给放置引擎。S050 pp. 11–14, 19–20 S048 pp. 27–28, 44–51 S045 pp. 29–30
SO-C/storage融合可共享设备,读写突发与入口流便需要统一容量和QoS。推理RA在两种profile中均采用此融合方式,训练RA还提供物理分离配置;跨host KV、embedding或分布式推理的关键依赖则根据实际路径进入后端预算。部署者可以分别观察数据预取供给率、checkpoint完成窗口、会话恢复P99、journal提交P99和元数据请求尾部,再追到相应网络与设备。S047 pp. 21–24, 57–59 S048 pp. 28, 45–46
这样形成的存储层级拥有明确的职责:HBM保障活跃步骤,暖池吸收短暂停顿,NVMe提供持续状态与快照,对象层保存长期资产,journal记录可恢复的进展。各层的价值取决于对象何时被消费、怎样跨层移动,以及哪一个确认允许任务继续。推理阶段迁移的具体链路见推理解耦与KV数据路径,全系统控制关系见系统架构的三层闭合。
