光电路交换的拓扑与时间匹配
从低频改接到作业内重构,连接 OCS、流量预测与端点恢复
按端口、插损和时间尺度比较 OCS 路线,连接 Jupiter、TPU、ACTINA 与 MixNet 的不同控制模型,并推导重构的完成时间盈亏平衡。
光电路交换 OCS 让集群的物理连接可编程:控制面先建立端点之间的光通路,数据随后沿既定路径传输。它节省中间 OEO 转换与逐包处理,同时把网络设计的重点移向拓扑、连接持续时间、插损和重构过程。对 AI Factory,最有价值的组合是把应用并行模式暴露给网络控制,再按合适的时间尺度改变物理连接。S057 pp.8–17,21–29
电路提供确定路径,分组层组织流量复用#
OCS 在光域连接端口,路径内没有电分组缓存、包头查找或中间再生。已建电路的数据传输因而避免该交换层的排队与缓冲抖动,且可在其光学工作波段和预算内承载不同协议、速率的信号。EPS 则提供逐包路由、负载分担、QoS、过滤和多流复用。两者在混合网络中分担不同责任。S057 pp.8–9
一对一连接使端口可达性成为显式资源。某 GPU 当前接向一个远端之后,发往其他目的地的流量需要端点复用、额外端口、间接路由或后续重构。已有电路内部没有队列,并不消除端点注入竞争与路由选择;控制面仍需考虑同时发出的流、匹配约束和空闲电路。OCS 的能耗优势与这种调度责任一起进入系统。
光学透明也意味着信号预算连续累积。S057 将无高功率光源或放大的实用 OCS 跳数概括为约一至两级,原因是每级插损持续消耗接收裕量。S057 p.9 在光电链路预算中计算过的 FAU、连接器、ODF 与纤段损耗,还需加入 OCS 的端口间损耗、均匀性、串扰与波长/偏振响应。多跳光网络需要依据实际器件重新闭合预算。
技术选择首先对应重构时间尺度#
OCS 机制的分类可用端口规模、切换时间、插损、锁存与监控能力共同描述。机器人系统通过机械移动连接光纤,像自动配线架一样工作,可在掉电后保留已建立的连接,适合秒到分钟级重配;自由空间 MEMS、液晶、压电等 beam-steering 类在综述表中归入毫秒级;硅光 MZI/MEMS 类被列为纳秒至微秒级;metasurface 类为微秒级。不同器件仍有各自端口数与损耗条件。S057 pp.10–13
| 机制类别 | 主要可调物理量 | 适合优先评估的约束 |
|---|---|---|
| 机器人配线 | 光纤端点的机械连接 | 重构频率、锁存、运动规划、端口规模 |
| MEMS/压电自由空间 | 光束方向与对准 | 振动、重复性、端口间损耗、反馈控制 |
| 液晶 | 偏振及光路控制 | 偏振多样性、插损、响应速度 |
| 硅光波导交换 | 相位、耦合、谐振状态 | 级联损耗、串扰、热调谐、驱动功耗 |
| 超表面 | 亚波长像素相位 | 光谱响应、转向角、端口密度、插损 |
这张分类表对应器件机制。网络可用的重构时间还包括控制器决定、流量排空、光开关动作、接收器重新锁定、FEC/链路训练、路由更新和应用恢复。一个纳秒级开关芯片只有与端点和控制软件共同设计,才可能形成同量级可用电路;一个毫秒级器件则可以通过提前计算和重叠执行服务更快的工作负载阶段。
从机房扩容到作业内重构逐步收紧控制闭环#
最慢的时间尺度是物理网络扩容和 spine 层改接。S057 介绍 Jupiter 的 OCS 替换 electrical spine,使 aggregation blocks 可随扩容增量连接,端口速率升级不再要求同代际 spine ASIC。该白皮书转引 Jupiter 的网络功耗下降 41%、CAPEX 下降 30% 等系统结果,收益与其拓扑、SDN 和部署方式共同相关。S057 pp.13–15 这个案例说明,重构频率较低也能产生价值,因为大部分数据在长期稳定电路上运行。
中间尺度是按作业组合加速器。TPUv4 案例把 16 台服务器、每台 4 个 TPU 组成 64 TPU 的 Cube;64 个 Cube 构成 4096 TPU 的 Superpod。OCS 位于 Cube 之间,Cube 内维持电互连;控制面按作业分配 Cube、构造 torus 等拓扑并绕过故障。内部非表面 TPU 的外部流量还需经其他 TPU 转发,因此物理分区与路由跳数仍参与性能。S057 pp.15–19
更快的尺度是在一个作业内部匹配通信阶段。张量并行、流水并行、数据并行和专家并行的通信对象、流量密度与同步频率不同。OCS 可以为持续的大流量集合配置更多直连带宽,EPS 保持其他流量与控制通信。其收益取决于阶段持续时间是否足以覆盖重构,以及下一阶段的通信矩阵能否提前确定。
用一次传输的完成时间核算重构收益#
设剩余数据量为 D,现有有效带宽为 B_old,新配置有效带宽为 B_new。本文给出一个用于工程筛选的模型:
各项分别为发现流量变化、求解配置、排空旧流量、物理切换、接收及协议恢复、确认新路径可用。只有 T_new<T_old,当前这批数据才从重构得到完成时间收益。若部分过程在计算阶段重叠,应从显性停顿中扣除可隐藏的时间,并保留预测失败和回退成本。
例如,旧路径有效 200Gb/s,新路径 400Gb/s,总显性重构成本为 2ms,则 D 需要大于 800Mbit,约 100MB,才能摊薄这次切换。这是本文的简化算例,假设带宽稳定且忽略其他竞争。若计算阶段能隐藏 1.8ms,剩余 0.2ms 的可见成本将使盈亏平衡数据量降到约 10MB。这样的模型比单独比较 switch time 更能指导 runtime。
MoE 把预测与光电混合推到同一处#
专家并行的 all-to-all 流量受 token 路由影响,通信对象及流量大小通常在计算后才明确。MixNet 的研究方案利用相邻迭代流量的时间相关性和局部 GPU 群组:S057 概述的典型群组为 8–32 个 GPU,可用较小 radix、毫秒级重构的 regional OCS 承接 EP,而 DP、PP 留在全局 EPS,机内 TP 继续使用本地 scale-up fabric。S057 pp.26–29
下图先看三条水平或局部路径的分工:上方蓝色 EPS 覆盖全局,下方绿色 OCS 只服务区域,服务器内部粉色 scale-up 连接本地 xPU。这种布局把需要快速统计复用的流量和可预测、可集中带宽的流量分配给不同网络。
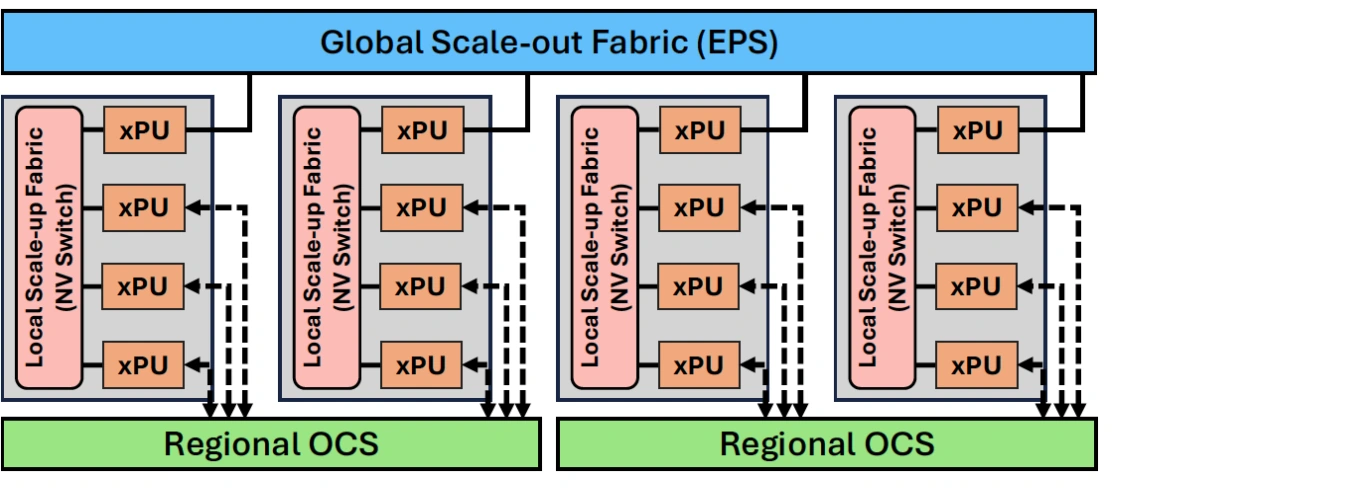
原图:S057,物理第 28 页,Figure 10,The MixNet network architecture;白皮书转引 MixNet 研究方案。S057 pp.26–29
其 runtime 在计算阶段按前一迭代预测下一轮 EP 流量,提前重配光路。S057 转引 MixNet 对 Mistral 8×7B 的仿真结果为相对静态 fat-tree 分组网络约 1.6 倍训练加速。S057 p.27 在工程验证中,应同时测预测准确度、未被光路覆盖的流量、端点缓冲、重构隐藏率以及 EPS 回退压力。模型 token 分布发生突变时,这些指标会比平均电路利用率更早显示问题。
另一类研究 ACTINA 用 OCS-BCube 与集成到 GPU 端的多端口、波长可重构收发器联合设计,将可调资源从“端口接向谁”扩展到“各方向分多少波长带宽”。S057 概述其评估相对 OCS 3D Torus 最高约 1.84 倍迭代性能、最高约 1.75 倍 tokens/J 改善,并给出多波长器件的实验示意。S057 pp.21–25 这些收益来自拓扑、端点光器件与流量控制的共同设计,评估时需要保留它们的组合条件。
故障恢复需要物理路径与作业状态协同#
控制器的输入可以表示为时间窗内的流量矩阵,元素描述端点对之间待传数据、带宽需求与截止时间。求解器将其映射为端口匹配和多条光路,再检查每条路径的光预算与端点能力。若一个端点在同一时刻连接数有限,需求矩阵就要被拆成多个可执行配置;配置切换顺序会影响完成时间和公平性。这里的矩阵与分解是对电路调度的工程表达,与 S057 提出的 traffic-aware control plane 和按 workload 重构方向相对应。S057 pp.13–17,21–29
实际 runtime 还需要对预测误差保持可观察。可以按每次重配记录预测字节、实际覆盖字节、未覆盖流量、空闲光路时间、重构期间端点缓冲峰值及回退路径负载;再按任务迭代统计通信完成时间和 tokens/J。一个预测器可能提高平均带宽利用率,却让少数未覆盖目的地形成 straggler,因此应同时看整体迭代尾部。对低精度工作负载,压缩改变 D,也会改变上面的重构盈亏平衡点;优化量化与优化电路的收益需要在同一工作负载状态下重新核算。
OCS 可将故障端点或交换单元绕开,并让多个设备共享一组备用光路径。控制面需要完成故障定位、受影响作业识别、备用资源分配、光连接切换和端点状态恢复。若备用路径的协议、容量与应用容错配合得当,作业可在较少回滚的情况下恢复;恢复时间还要计入新链路训练和软件状态一致性。S057 pp.19–21
因此故障输入应来自可定位的链路证据:host-side 与 media-side 的 BER、LOS/LOL、FEC 尾部、远端状态、光功率和事件时间线。它们可以区分 ASIC 电口、模块、光纤、OCS 光路和远端端点,再选择最小范围的隔离动作。具体消息与遥测机制见光互连可观测性。开放光子平台的 COM–RAS 构想也把设计裕量与现场故障相连,使物理重构拥有可核验的触发条件。S055 pp.13–15,38–40 S056 pp.75–76,188
AI Factory 可以沿三个层次验证 OCS:先在扩容与故障恢复中验证低频、长持续电路;再把作业调度器与拓扑编排相连;最后进入计算通信重叠和波长级带宽分配。每一层都增加控制闭环要求,也扩大物理资源按负载组织的空间。器件速度、拓扑容量和 runtime 预测在同一时间模型下闭合,才会形成可持续的训练吞吐收益。
