硅光平台的封装、制造与开放集成
用接口契约连接光引擎、PDK、已知良品和机架无源设施
围绕出线几何、WDM/BiDi、封装维修与制造分布建立光子平台论证,解释 PKGD、PDK 工程流程、四层测试和现场数据的关系。
硅光进入 AI Factory 的系统价值,在于把高带宽连接从长距离电通道的损耗与封装出线限制中释放出来,并让光引擎、无源光设施和计算平台按共同接口演进。器件密度、封装耦合、晶圆测试、现场维修与多供应商互操作必须一起成立,才能把一条实验链路扩展成可制造的平台。开放光子架构 S056 与短距接口综述 S058 给出了从光子器件到机架设施的这组约束。S056 pp.44–81,206–215 S058 pp.52–77
器件路线与集成位置分别选择#
光引擎技术涵盖外置连续波激光驱动的 SiPh、集成光源 SiPh、直接调制 VCSEL、micro-LED,以及带激光和 DSP 的 coherent 类。它们在光源、调制、纤型、密度、距离和控制复杂度上各有取舍。S056 将 OE technology class 与 placement class 分开:一种器件路线可以部署在多个位置,某个放置位置也可以承接不同光学实现。S056 pp.61–63,66–79
硅光的调制器路径主要包含微环谐振器与 Mach–Zehnder 等。微环可在同一波导上选择相应波长完成调制并复用,密集 WDM 有利于减少独立 mux 级数;相应设计需要管理谐振波长、温漂和通道间串扰。MZI 的传输特征与波长响应不同,构造 WDM 时需计入独立复用器及其插损。S056 对两者给出结构性损耗比较,具体数值随器件和波长数变化。S056 pp.61–65,240–249
400G/lane 又使材料成为关键变量。S058 讨论更高速 IMDD 时的调制带宽、硅波导与高速材料的混合集成、器件尺寸和量产流程兼容性,并把 NRZ+WDM 的 slow-and-wide 作为另一条扩展路线。S058 pp.70–75 因而平台应保留对多种技术的容纳能力,同时在每条实际链路上冻结可互通的光波形、波长、FEC 与接口条件。
出线几何决定集成的下一道边界#
把 OE 移近 ASIC 能缩短电路径,却仍需把光纤从封装引出。传统边缘出线的可用资源大致随边长 L 增长,面积出线的潜力随 L² 增长;S056 用 APO 描述从 die face 组织 I/O 的几何方向,区别于 CPO、NPO 等沿封装周边放置引擎的方案。S056 pp.44–49,66–74,273–276
下面原图首先看中心计算芯片周围的光引擎,再沿箭头看 FAU 与光纤。引擎占用基板区域,FAU 占用出线边界,二者要同时容纳在封装、冷却和机械固定空间内;缩短电路径后,光纤装配可能接替电通道成为限制。
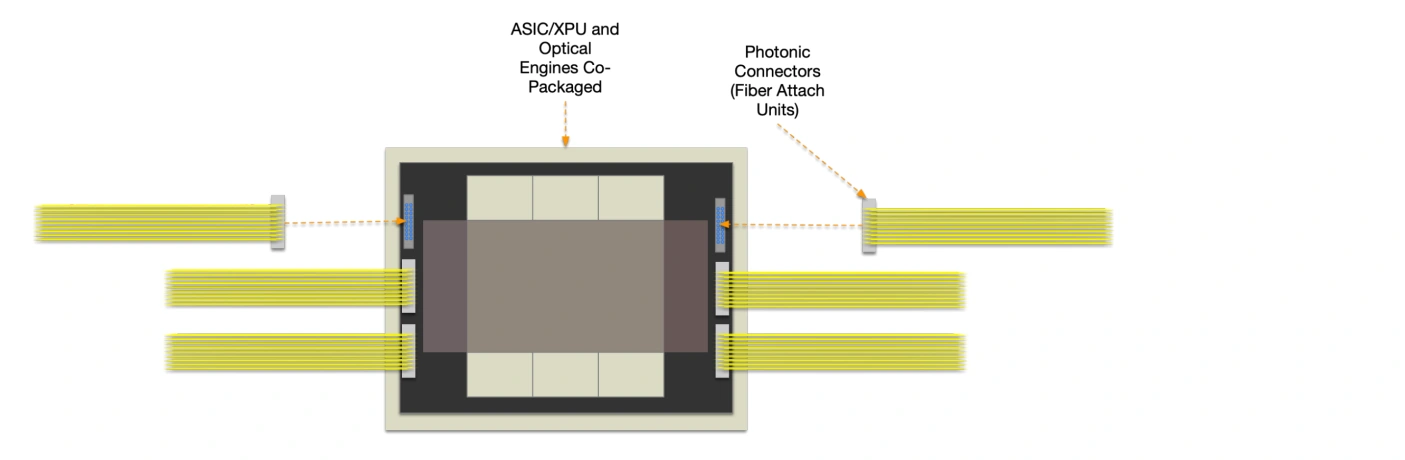
原图:S056,物理第 67 页,Figure 5.5,Co-Packaged Optics and Fiber Attach Units。S056 pp.62–68
FAU 的 fiber pitch、每 port 光纤数、alignment tolerance、光纤弯曲半径和 keep-out 共同定义 attach envelope。S056 给出常见 250µm、可实现更高密度的 127µm 阵列间距作为讨论基础,提出用最大 FAU 宽度与对准等级形成接口契约,并记录每 facet 插损、通道均匀性、回损、偏振相关损耗与热老化漂移。S056 pp.62–65 这些条件比单一“每毫米多少 Tb/s”更直接决定能否装配。
波长与双向复用重新分配纤数和端口#
总带宽可以沿三轴扩展:每纤波长数、每波长有效速率,以及同纤双向传输。S056 的候选 profile 表按双向总 payload 计量,224G PAM4 列采用每波长约 200Gb/s 有效速率:4+4 波长单纤 BiDi 对应 1.6Tb/s,8+8 对应 3.2Tb/s,16+16 对应 6.4Tb/s;后续速率代际再扩展。这些列包含路线目标,表下注明当前引用的 Profile B 演示约为 800Gb/s aggregate。S056 pp.147–152
以 8+8 为例,8 个波长向一个方向传输,另 8 个向相反方向,总计 16 个波长;计算纤数时还需明确每根纤承载的方向和波长集合。密集 WDM 减少 FAU 和面板占用,但独立目的地的逻辑端口可能需要 demux 与额外路由。S058 特别指出,高 radix 若需要每 lane 独立连接,WDM 与 fiber shuffle 的组合会影响成本及面板密度。S058 pp.56–59
因此 Link Profile 应同时包含波长分配、connectorization、极性、方向、有效速率与遥测要求。不同链路可以采用不同 profile,同一条链路两端要匹配。共享无源设施也需要确认纤型、波段、连接器损耗和功率承受能力,形成真正可接入的接口。S056 pp.147–154
模块化从前面板延伸到托盘和光服务区#
S056 的五个 placement class 分别是 CPO、NPO、S-NPO、M-NPO、FPO。CPO 把 OE 和 ASIC 放在同一封装基板,通常以 package 为 FRU;NPO 可按焊接或插座实现形成不同维修粒度;S-NPO 在基板插座上替换 OE 或铜缆组件;M-NPO 以可拆卸 mezzanine 承载子系统;FPO 保留前面板模块更换边界。S056 pp.66–80 这些选择同时决定电段损耗、供应商交接点、热耦合与故障影响范围。
平台层进一步将无源光设施与有源 OE 分开。托盘内 raceway 管理光纤路径,ODF/shuffle 组织端点映射与故障断点,faceplate 提供可接触的连接和标签,rear blind-mate 支持特定安装方式,ELS 服务区安置可维修光源。不同 OE 在同一托盘分别服务 scale-up、scale-out 或其他加速器连接,再由共同的光纤管理结构接入机架。S056 pp.112–135,145–146
外置光源把 laser 从高功率 ASIC 附近移到更容易更换的位置,代价是供光路径损耗、连接器、冗余切换与共因故障管理。将 laser 留在内部也可以通过冗余降低维修频率,但温度、激光寿命和散热路径要与 ASIC 分别预算。S058 将约 40°C 条件下的低 FIT 光源与更高温条件的可靠性差异放入系统讨论,强调背板内方案的修复成本。S058 pp.63–65
共享供光可用恢复域来限制影响。S056 建议尽量将一个 ELSFP 的资源限制在同一可隔离域内,并在域内把多个光源条带化分配给 OE、lane 或波长组。若四路均匀条带分别承担四分之一带宽,单光源故障的初始损失目标约为 25%,随后由冗余、流量迁移或作业重调度继续恢复。管理系统同时保留光源到恢复域的映射,使光源故障可以对应到调度器理解的节点或 fabric slice。S056 pp.123–125
PDK、已知良品与封装良率形成连续数据链#
从制造角度,光引擎的交付单位需要包含可预测的器件模型、工艺分布和实测参数。S056 提出 Photonic Known-Good-Die 方法的缺口:装配前须验证光学插损、消光比、responsivity、波长准确性,验证光电接口 SI,并验证 grating 或 edge coupler 的光耦合完整性。这些轴超出了传统 silicon KGD 的电学测试范围。S056 pp.206–207,215
据此组织工程流程时,PDK 应在设计端连接到测试端:器件库包含波导、耦合器、调制器、探测器、加热器及电接口的模型;工艺角覆盖几何尺寸、损耗、谐振波长和温度响应;版图检查约束光路间距、弯曲、金属、热隔离和测试结构;封装模型继续加入 FAU 对准、键合、连接器与供光损耗。这里的 PDK 工作项是依据上述测试需求提出的工程组织方式,S056 提供的是 PKGD 与接口协同建议。S056 pp.80–81,206–207,215
关键在于让设计假设能被量产数据更新。某器件在典型工艺角的 insertion loss 很低,但 wafer 边缘、温度边界或键合后分布较宽,系统就要提高功率或收紧筛选;这会影响良率、成本和热预算。若只有最终 assembled package 才能发现坏 die,昂贵 ASIC 与其他良好裸片会共同承担报废风险。PKGD 的价值是尽早缩小这种风险,并为封装后增量损耗留下可追踪基线。
从试验载具到现场遥测验证八个闭合条件#
S056 的 system integrator validation matrix 包含电裕量、光预算、热、电源、管理、维修动作及故障隔离七维,再加入制造成熟度作为第八维。单模耦合对微小横向偏差敏感,胶固化收缩、热循环和操作后位移使量产损耗呈分布,单次装配的最好结果不足以推导整线良率。S056 pp.80–81
验证可以分成相互关联的载具。生产 host 载具先冻结机壳、keep-out、冷却和纤路;独立 coupling 载具从单纤到 FAU 逐步增加密度,测初次连接、热循环和重新附着;无源平面可用 loopback 或 surrogate 提前检验;装配后再测具体 topology 的插损、COM 和 FEC margin。源文进一步建议把工厂 EOL 的 Tx/Rx power、laser bias、温度和链路质量送入平台管理,映射到 OE、FAU bond、connector、ODF、ELS 或热控问题。S056 pp.80–81,215
运行阶段由增强遥测延续这条链:host/media 两侧 SNR、FEC histogram、事件时间和远端状态把退化定位到可替换边界。设计时的 COM、制造时的损耗分布和现场故障由此可互相校准。S056 的四层测试建议覆盖 foundry、component、assembly、system/field,把互操作测试和运行可观察性放进同一个交付过程。S056 pp.75–81,188,215
平台演进保留协议与计算结构的选择#
可以用一次供应商替换来检验开放程度。设同一托盘引入第二家 NPO:机械上检查 keep-out、安装基准和纤路出口;电源上检查电压、峰值电流、时序与隔离;信号上以同一 host channel 模型验证 COM、返回损耗和 BER;热上比较光源和 OE 的温度边界;管理上验证传感器单位、lane 映射、告警、事件与固件版本。随后在共同 Link Profile 下接入远端,完成跨厂商互通、热循环和现场服务动作。S056 的五维契约与八维验证结构可作为这份交接矩阵的基础。S056 pp.74–81
制造验收还可把良率与系统功率联系起来。若筛选规则放宽,部分低裕量 OE 可能需要更高发射功率、更强均衡或更保守 FEC 才能稳定工作;若筛选更严,装配前成本与可用裸片比例会变化。将这些配置随器件序列号写入 EOL 记录,再与现场能耗、错误和维修数据关联,就能比较“较便宜器件加运行补偿”与“较高筛选成本换裕量”的总成本。这个分析框架延续 S056 的 effective pJ/bit 和制造分布思想,实际参数来自候选器件及产线测量。S056 pp.81,137–145,215
S056 将水平 Class H 托盘作为近端平台路径,将垂直 Class V canister 作为更高密度的规划方向;光子互连为两者提供不同于高复杂度铜 midplane 的连接方式。其 Scale-DSA 概念把跨架构专用加速资源连接纳入同一无源基础设施,memory-semantic 与 fabric-class 业务各采用相应 profile 与上层协议。S056 pp.54–61,83–90,147–154,177–184 光学可达性扩大了组合空间,协议桥接、内存语义与调度仍需由计算系统设计完成。
技术路线可先从可服务的 LPO/RTLR、NPO 建立多机架经验,再根据裕量、可靠性和密度推进 CPO、面积出线及更高波长密度。S058 pp.69–72 每一步都用完整链路预算决定可行位置,用实际维修与制造数据决定集成深度。硅光平台的长期竞争力由器件、PDK、封装、测试、无源设施与运行数据共同积累,这组闭环决定了开放接口能否持续跨越计算代际。
