Scale-up Ethernet 的事务、打包与链路契约
从 XPU NoC 到 ESUN 转发,展开 SUE-T 的内存命令传输路径
解释命令打包、PDC 状态、Delivery/Operational ACK、AXI 映射与 ESUN 精简头,分析小事务线效率、端点面积和链路恢复之间的取舍。
Scale-up Ethernet 的核心工程问题,是把 XPU 的内存事务送进以太网交换结构,并在极短的通信路径上控制端点面积、包头开销和状态寿命。ESUN 提供精简转发封装及链路能力要求,SUE-T 提供事务映射、打包和可靠交付框架。二者组合后,一次远端 Store 可以从 XPU NoC 出发,以多个命令共享一个网络包,并在远端执行后用紧凑确认返回。S043 pp. 9–15 S041 pp. 7–16
从内存命令追到线上的包#
SUE-T 面向共享内存、单边操作语义:源端发起命令,目标端由相应内存接口处理,源端获得完成。内存注册、保护域和具体地址翻译由 XPU 系统提供。协议把命令映射为 UET Unified Local 语义,再以 RODL 负责包交付;链路承载可以采用 ESUN、UEC UFH,或标准 UDP/IP/Ethernet。S041 pp. 7–13, 16–17, 23–24
沿一条 Store 路径展开,XPU 首先给出目标标识、opcode、地址、长度、排序模式和数据。映射层形成 CMD_PDU,必要时调用实现自己的地址翻译,然后按 {dstXPU,TC} 进入发送队列。调度器选择当前具备缓冲与流控资格的队列,打包该队列中可用的若干命令;可靠性层加入 8B RODL 头,其中有 PDC 标识和 PSN,再加上网络封装、完整性校验并送往 MAC/PHY。S041 pp. 10–13
接收路径先检查 Ethernet 与网络封装,再由可靠性层检查预期 PSN;通过后进入接收缓冲,拆出各 CMD_PDU,映射回 XPU 接口并提交。下图应从上方绿色发送路径读到右侧 MAC/PHY,再沿下方反向读到目标 NoC 与 LLC/HBM;红色 PFC/CBFC 箭头显示队列资格如何受到链路接收空间约束。
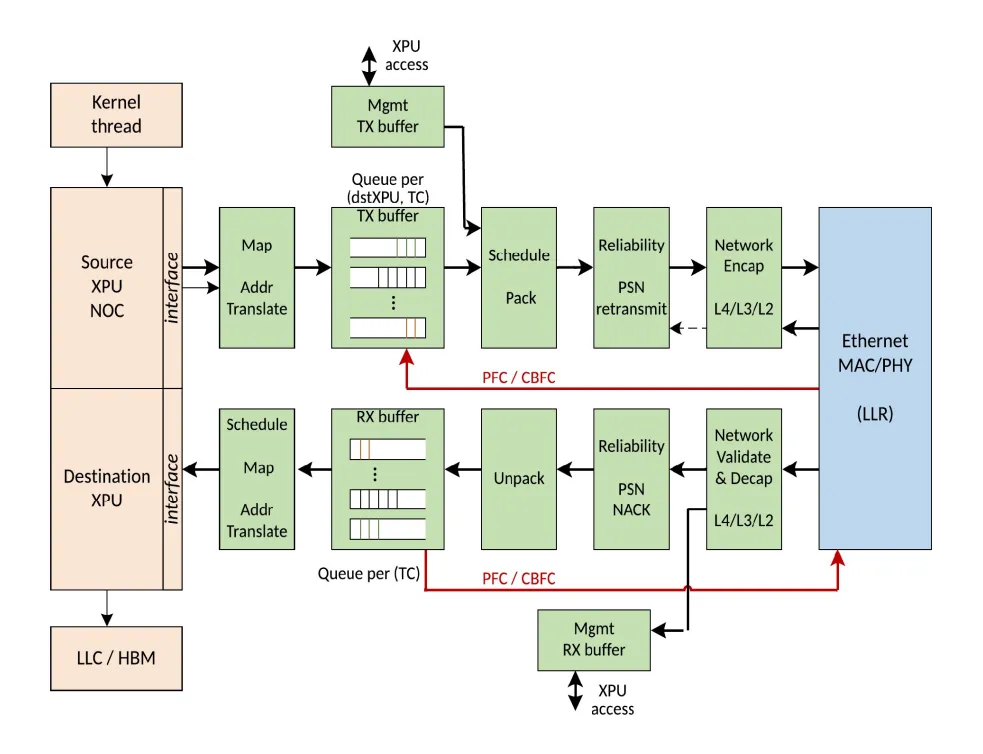
原图:S041,物理第 12 页,Figure 3;接收检查与确认步骤续于第 13 页。
PDC 是包交付上下文,保存下一 PSN、确认 PSN、超时等连接状态。小系统可以为每个 {远端 XPU,TC} 保留上下文;目的规模较大时,可采用动态分配,用较少 PDC 服务更多目的端。规格以 1K PDC 对应 8K XPU 作为取舍示例,体现的是硅面积与活跃通信集合之间的关系。S041 pp. 20–22
机会打包把排队转化为包头摊销#
短事务的线效率受到每包固定开销限制。SUE-T 为每个事务提供 12B 语义头,地址可用相对前一事务的偏移表达时,使用 8B 压缩变体;还可携带最多 16B XPU 专用状态。一包最多容纳 16 个事务,多个命令共享网络封装、可靠性头、校验与链路固定开销。S041 pp. 11, 16–19
打包采用工作保持策略:可发送队列里只有一个事务就发一个,多个事务已经排在那里才一起带走。调度器不为攒足一包而延迟事务。XPU 到 SUE-T 的入口带宽可能高于以太网出口,这种速率差本身会形成可利用的队列积累;更大的缓冲增加合包机会,同时增加面积和驻留容量。配置还要限制所有 Store/Atomic 的总请求数据,以及 Load/Fetching Atomic 的预期总响应数据,文档给出的可配置限制为 2KB、4KB 或 8KB。S041 pp. 17–19
可以据此构造一个打包例子:同一目的与 TC 下已有若干 Store,调度器一次取出能够放进当前包的命令;另一个目的的命令留在自己的队列,等待下一轮资格选择。若共享动态队列数远少于 N×K 个 {目的,TC} 组合,高度分散的小消息可能因队列冲突产生阻塞。专用队列、动态缓冲和调度规则共同决定这部分尾延迟。S041 pp. 18–19
事务长度需要按接口路径理解。范围表以每事务最多 256B 数据描述小事务基线;后面的 AXI 适配明确支持最长 4KB burst,且事务不得跨越 4KB 页边界。AXI 映射中,4096B 长度需要使用 ac=0 的非压缩地址格式,增加 4B 头部。实现应把所采用的命令接口与长度能力写入集成规格,以便编译器和 XPU 发起逻辑正确分段。S041 p. 8 S041 pp. 28–29
确认压缩用端点状态交换线效率#
Delivery ACK 与 Operational ACK 决定响应状态存在于哪里。Delivery ACK 表示 CMD_PDU 已交给目标 XPU;目标 XPU 对操作的响应被作为另一条命令运回,由 XPU 接口关联原请求。SUE-T 的收发路径相对独立,命令内容可以保持不透明。Store 的传输确认与 Store 的 XPU 响应因此是两个事件。S041 pp. 13–14
Operational ACK 把关联责任放进 SUE-T。发送端记录每个命令状态,接收端按 {PSN,CMD_PDU} 等待包内所有命令的 XPU 响应。若全部成功且没有返回数据,只需确认一个 PSN,发送端就可为这一包内的所有命令生成相应成功响应;Load、Fetching Atomic 的数据以及操作错误由专用 ACK 包携带。S041 pp. 14–16
这是一种明确的状态与带宽交换。规范中的开销示例采用 UFH 16 位地址,打包两个及以上 CMD_PDU 时,Operational ACK 的 wire efficiency 可超过 90%;其对照为使用 16B 响应命令的 Delivery ACK,低于 80%。这些数字来自所述封装和响应模型,适合用于包开销预算;实际作业收益还取决于合包比例、命令类型、接口状态量与等待时间。S041 p. 15
操作“完成”还取决于内存可见性。SUE-T 支持全局可观察性控制,由 XPU 在数据放入内存后才回响应。AXI 集成章节列出了从完整远端内存往返,到目标队列入队,再到源网络队列入队等实现优化点;不同完成点覆盖的错误范围和其他观察者可见性随之变化。无论采用哪种本地提前完成策略,源端最终仍需要远端响应或 ACK/NAK 来清理未完成请求资源。S041 pp. 16, 29–30
接口上的附加状态也会改变这种取舍。AXI 适配提供 60 位 AxADDR、最多 16 位 AxID,以及可配置为 0、32、64 或 128 位的 AxUSER。AxID 与 PDCID 双射映射,接收端可由连接状态重建原 AxID;AxUSER 则作为不透明信息通过扩展头传递。若某类事务实际只需较少附加语义,可分别为读请求、写请求及其响应配置合适宽度,减少小包中的固定开销。S041 pp. 27–29
压缩地址格式还继承前一个非压缩事务的扩展头长度。后续命令改变扩展长度时,要重新使用 ac=0 格式,恢复可自描述的边界。这说明合包效率同时受到目的端、流量类别、地址局部性与事务附加状态的影响。硬件集成和工作负载建模应保留这些分布,才能从平均事务长度进一步推导实际包长与端点状态需求。S041 p. 29
ESUN 把短消息转发所需信息压进 4B#
ESUN 使用 L2 地址转发,用 4B EH 替换 20–40B IP 头,同时保留拥塞反馈、类别区分、寻路熵和环路约束。EH 字段由 2 位 ECN、3 位 CoS、1 位 F、16 位 Flow Label、4 位 TTL、2 位用户自定义和 2 位 Revision 组成。S043 pp. 10–12
| EH 字段 | 进入转发链路后的作用 | 集成时的约束 |
|---|---|---|
| ECN,2bit | 反馈持续拥塞 | 端点宣布能力并响应标记,交换机在相应条件标记 |
| CoS,3bit | 映射 Traffic Class | EH-CoS 优先于同时存在的 VLAN 或 CBFC 类别 |
| F 与 Flow Label | 提供路径选择熵 | F 有效时按 Flow Label 确定性转发 |
| TTL,4bit | 每跳递减、到零丢弃 | 防止意外环路;更新后重算 FCS |
| UD 与 Revision | 端点自定义及版本演进 | Rev1.0 使用 00;按共同格式解析 |
依据:S043 pp. 11–14。
交换机使用静态配置的 48 位目标地址转发,地址学习和老化被移出这条数据路径;未知地址的 ESUN 包也不进行广播。因此,地址表完整性与变更一致性会直接影响连接可达性。安全方面,MACsec 可以保护点对点 Ethernet 链路,端到端加密由上层设计选择。S043 pp. 13–15
封装与传输层还有各自的识别契约。SUE-T 使用 UDP/IP 时以 UDP 目的端口 4793 识别 UET,UFH 路径使用 EtherType 0xE790,ESUN 路径则依靠网络范围配置推断所承载的 UET;RODL 类型进一步由 UET 头字段给出。这些差异要求部署工具同时表达封装类型和传输 profile。S041 pp. 23–24
有序轻量传输把约束下沉到链路#
SUE-T 的 RODL 采用有序交付和可选 GoBackN,目标是缩减连接状态。每包丢失可能引发后续多包重发,省略重传时则使连接直接失败,因此所有 SUE-T 流量类别都需要 PFC 或 CBFC 提供无损网络服务,并由 LLR 减少链路误码暴露。请求与响应还要处于不同 TC,避免响应被请求占满的资源堵住。S041 pp. 18–22
ESUN 的能力要求呈现出设备角色差异:交换机必须支持 PFC、CBFC 和 LLR,并可逐端口配置后两者;端点必须支持 PFC,CBFC 与 LLR 为可选能力。LLR 针对 BER 引发的链路错误,其他原因造成的包丢失仍由端到端恢复设计处理。部署 SUE-T 的特定实现时,需要把链路能力组合与是否启用 GoBackN 一起确认。S043 pp. 13–15
单跳是这套成本结构的重要条件。SUE-T 为单交换机跳数进行优化,范围表给出 1500B 包、单跳网络下小于 2μs RTT 的目标,以及最多 16K XPU 的设计范围。多跳会改变时延、拥塞与状态预算;规格把基于 CSIG 的多跳拥塞控制、转向 UET ROD/NSCC 或 RCCC,以及端口失效后移动连接等列为后续工作。S041 pp. 8–9, 20–21
因此,Scale-up 系统规划应从 XPU 接口和故障模型向外推导:同 AxID 下读与写各自有序,读写之间以及不同 AxID 之间需要额外定义依赖;响应是否等待内存可见,决定同步点含义;打包比例决定小事务线效率;是否保留重传决定链路之外的残余错误如何结束连接。S041 pp. 27–30 可靠传输中的 Falcon、MRC 提供另一种乱序和恢复成本分配,拥塞与多路径展开了多跳反馈,而Fabric 运维负责把这组接口契约转成可实施的故障与维护流程。
