光电链路的距离、功耗与维修边界
沿 ASIC 到远端 ASIC 核算铜、retimer、LPO、NPO 与 CPO
用完整信号路径解释铜光切换条件,比较光引擎位置与重定时策略,连接电裕量、光预算、器件封装、热可靠性和 400G/lane 路线。
高速 AI 互连的铜光边界取决于完整路径:ASIC 封装、板上出线、连接器、线缆、retimer、光引擎和远端接收器共同消耗信号裕量、时延和功耗。链路距离只是这些预算的一项输入。随着每 lane 速率提升,设计选择逐渐从“线缆种类”深入到光引擎放置、均衡责任和可维修单元,板级与封装级的决策因而直接影响集群拓扑。S058 pp.39–57 S056 pp.31–34,66–79
在统一参考面上核算电通道#
短距光接口报告并列了两组电接口:PCIe Gen7 为 128Gb/s PAM4,Nyquist 频率 32GHz,pin-to-pin 损耗预算约 24dB,不含封装;IEEE 802.3dj 为 212.5Gb/s PAM4,Nyquist 频率 53.125GHz,系统损耗预算约 40dB,包含封装。两者列出的约 1m 被动线缆组件预算分别为 11dB 和 17dB。S058 p.39 只有先对齐参考面,预算相减才有工程意义。
报告在这些假设下把仅用被动铜的总体路径估计为约 1.5m,并讨论了内部 flyover 线缆减少 PCB 损耗、将更多预算留给外部线缆的办法。200G/lane 示例中,NPC 加 flyover 可支持约 1.4m 外部线缆;有源线缆把 repeater 放在 cable paddle card 上,可将线缆延伸到 2.5–3m 一类路径。S058 pp.40–48 对机架结构,走线绕过导轨、穿过背板、从顶部连接到底部,都使实际线长明显大于端点直线距离。
因此电链路预算可写成各段插损之和,但验收还要覆盖反射、串扰、模式转换、噪声、抖动和均衡能力。开放光子架构使用 Channel Operating Margin 或对应标准维护的等效指标,把这些效应合并为可工作的裕量。尤其在 224G 及以上,连接器与阻抗不连续引起的反射同样可能成为约束。S056 pp.31–34,136–139
retimer 用重新判决换距离与可恢复性#
retimer 在路径中重新恢复时钟、判决数据并发出信号,使后续段获得新的电信号起点。这让系统可以跨越单段损耗预算,也引入额外电源、散热、时钟与管理依赖。重新判决存在把错误锁定到输出的可能,因而链路质量需要看整条路径的 FEC 与重试行为。S058 pp.53–56
时延的尺度值得单独核算。S058 用一个典型 retimer 约 50ns 与光纤传播约 5ns/m 作比较,因此去掉一颗该类 retimer,可抵消增加约 10m 光纤的传播时间。S056 的另一个架构估算采用每 DSP/retimer stage 约 8–10ns、多级路径累计约 40–120ns。两份材料对应不同实现口径;具体设计应以候选器件和工作模式的实测或确定性规格填入模型。S058 p.56 S056 pp.150,276
板级多供应商设计还要解决 footprint。信号调理器规范定义 x8、x16、x24 双向封装,尺寸分别为 22×15、22×22、33×22mm,对应 16、32、48 个 SerDes lane。它把高速引脚、低速管理、六个电源 islands、出线与包内损耗预算统一起来,目标包括最高 256Gb/s PAM4 和约 200mil 厚 PCB 的制造条件。S064 pp.7–14
同一 footprint 下仍要配置 AC coupling、供电和软件。规范在 256Gb/s PAM4 对 BGA ball 到 die bump 的封装插损给出 RX<3.25dB、TX<2.75dB 上限,同时将 TDP、启动序列和编程模型留给器件方案。S064 pp.7,13–14,20 这为替代料提供了可复用的板级物理边界,完整替换验证仍包含电源、热和固件适配。
光引擎放置与重定时方式形成两个设计轴#
下面原图可以横向追踪同一条端到端连接,比较各行在前面板前后安排了哪些组件。CPO、NPO 和前面板方案改变电段长度,LPO 与 fully retimed 方案改变信号处理位置,两组选择共同组成连续的工程空间。
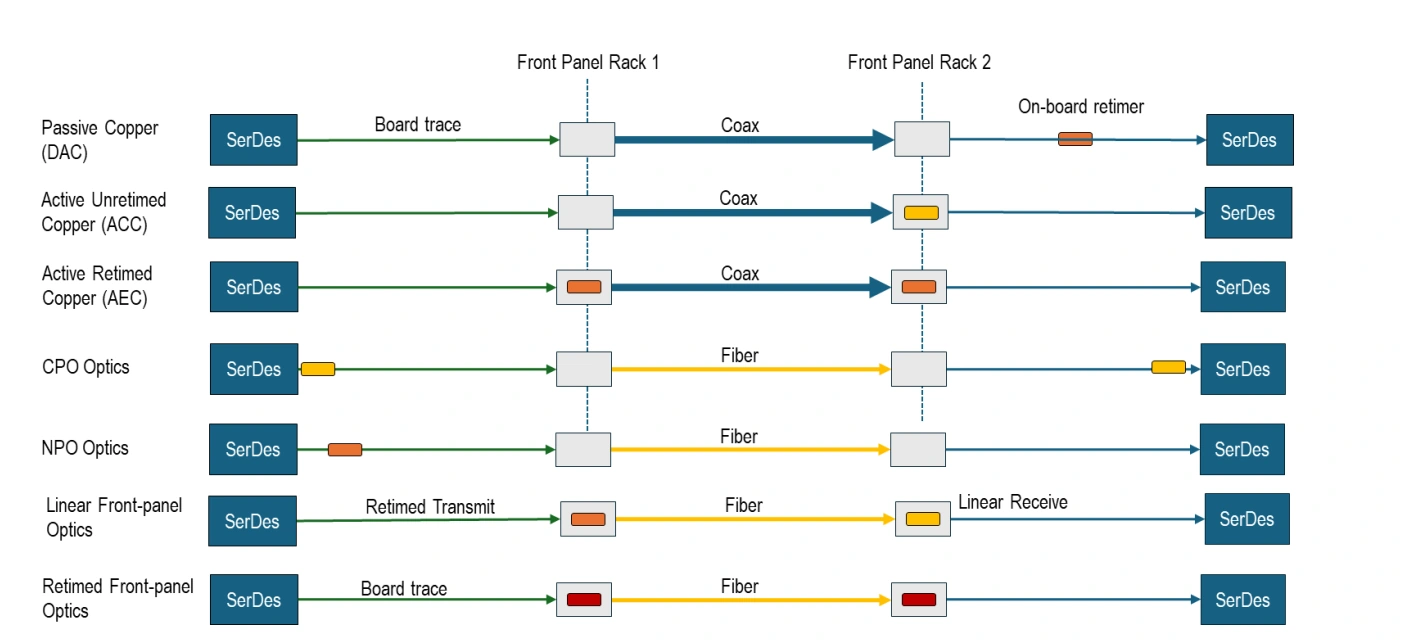
原图:S058,物理第 53 页,Figure 6-1,Continuum of Link Options。S058 pp.52–54
光引擎放在前面板时,模块容易直接更换,ASIC 至模块之间则保留较长电路径。NPO 把引擎移到封装附近的主板上,缩短 PCB 电段;CPO 把光引擎放进 ASIC 所在的封装基板,进一步减少电路径与连接器。开放光子架构还列出 socketed NPO 与 mezzanine NPO:前者在基板插座上形成可替换器件边界,后者以 ASIC+OE 子系统为可替换单元。S056 pp.66–79
重定时方式与这些位置分别配置。fully retimed 模块承担更多 CDR/DSP,较容易隔离两端电通道;LPO 将部分处理能力留给主机 SerDes,模块主要传递线性信号,功耗较低,但更依赖 host、模块和媒体全路径联合表征。half-retimed 则在两者之间分配责任。采用 CPO 也需要明确 FEC、gearbox、DSP 和 laser 的分布;集成位置本身并不决定所有信号处理方式。S058 pp.53,69–72 S056 pp.75–79
S058 的候选方案表在 200G/lane 前面板方案中列出 fully retimed 约 15pJ/b、half-retimed 约 10pJ/b、LPO 约 6pJ/b,CPO 候选约 4–5pJ/b,并同时列有后续代际目标。这些值适合辨认方案构成,实际比较应固定单端或双端、是否含 host SerDes、激光、冷却与 FEC 的计量范围。S058 pp.69–72 对一个单向有效速率 1Tb/s、同一计量边界下能耗 5pJ/b 的工程算例,功耗为 5W;若该值是单端口径,整条链路还应计入远端及其他未覆盖组件。
光路把距离预算转成连接与维护预算#
在机架和跨机架短距路径中,光纤本身的衰减较小,FAU、连接器、shuffle、ODF 和 OCS 的插损常更影响预算。S056 用每对洁净生产连接器约 0.5dB 作为架构估算:直接键合的 engine-to-engine span 可不含服务连接器,同托盘服务点、托盘间连接、分配框和跨机架 shuffle 会逐级增加连接器数量。S056 pp.33–35
一个工程预算可写为 P_rx=P_tx−L_attach−L_connector−L_switch−L_fiber−L_other,并为制造偏差、温漂、老化和维护后重插保留余量。插入一个可断开的服务点,既消耗光预算,也缩小故障定位和维修范围。为减少 0.5dB 而取消所有中间断点,可能把一次光纤或污染故障扩大为整托盘拆卸;多加断点又可能提高光源功率需求。这正是封装、线缆和运维要同时参与设计的原因。S056 pp.62–65,74–81,188
端口扩展还受到出线密度约束。高 lane 数的并行单波长方案消耗更多光纤;WDM 把多个波长复用到单纤,BiDi 在同纤上分配双向波长集合。减少光纤有利于 FAU 和面板密度,但逻辑端口若需独立路由,还要把波长重新分离,交换与 shuffle 的组织由此改变。S058 pp.55–59 S056 pp.147–152 这部分制造与接口问题在硅光平台的开放集成中展开。
400G/lane 让调制与接口重新耦合#
连接器的可维护性可以通过实际动作检验:技术员能否看到标签、检查端面、清洁后复插,能否拔出一个模块而不触碰邻近纤束,弯曲半径与冷板、管路是否冲突。测试路径还应覆盖最短和最长线、不同连接器数量,以及维护后再次运行的误码与功率。S056 对无源基础设施提出检验、清洁、service motion、breakpoint 和标签的接口条件;这些操作条件会消耗空间,但也降低长纤束场景中的维修时间与误插概率。S056 pp.114–120,126–135
对机架内两端路径,可以先制作一份组件账本。假设比较“前面板 retimed 光模块”和“封装附近线性 OE”,两者共用相同的光纤距离、FEC 目标和有效速率。前者的 host trace、cage、CDR/DSP、激光及远端镜像组件逐项列入;后者的短电通道、OE、外置或内置光源、控制与供光路径同样列入。损耗按发射参考面到接收参考面累计,功率按同时工作的两端累计,时延则拆为传播、处理、缓冲与故障重试。只有明确这些共同条件,模块级 pJ/b 差异才可转成整条连接的预算。S058 pp.52–56,69–72
再把两套路径放进相同负载下检查温度。靠近 ASIC 的 OE 得到更短电段,也可能面对更高温环境和更复杂的热耦合;外置激光减少这部分热压力,但增加供光、连接和监控对象。S056 因而把 laser case 温度、梯度、热瞬态、波长稳定裕量和寿命期光功率退化列入放置边界的契约。S056 pp.77–79 对液冷平台,流量和入口水温改变时,需要观察 ASIC 与光学区域各自的温度约束,以及压力下光功率、BER 和失锁事件如何随时间变化。
可靠性验收也应使用相同统计口径。S058 的一个示例将 72 加速器机架的铜连接直接换成 1296 个 800G retimed 模块,按每模块 12.5W 算得到约 16kW 附加功耗,并指出模块数量会叠加系统失效率。S058 pp.61–63 这个假设算例说明,拓扑需要多少端点与模块,本身就会影响热和可靠性;减少转换次数、选择更合适的集成度、保留备用资源与缩短诊断维修时间,应与单链路效率一起比较。
448Gb/s PAM4 对应约 112GHz Nyquist,铜通道在这一频段承受更大损耗,因此更高阶 PAM 可以用较低符号率换取距离,但也要求更好的线性度与信噪比。光 IMDD 的代价不同:热噪声之外还有随光功率增加的 shot noise、RIN,以及反射相关的干涉噪声。S058 因而讨论铜侧可能偏好 PAM6、光侧仍偏好 PAM4 的分化。S058 pp.73–77
当两侧调制或 lane-rate mapping 不匹配,边界需要 gearbox、DSP 或 retiming,原先基于透明线性路径的能耗和时延优势会改变。另一条路线是 slow-and-wide:用较低速 NRZ、多 lane 或多波长扩展总带宽,代价转移到 EIC、FAU、纤芯数量和制造精度。S058 pp.70–75 因此代际路线应同时给出信号格式、放置方式、媒体和维修策略,避免先冻结机械系统再补链路。
最终验收应沿 ASIC 到远端 ASIC 的路径检查裕量、FEC 尾部、重试、链路恢复、功耗及服务操作。其时间与故障数据由增强光遥测接回平台,拓扑与重构开销由OCS 架构继续约束。完整路径上的稳定有效字节率,决定了链路能为计算释放多少吞吐。
