芯粒系统语义与封装内传输分层
FCSA 的系统责任、BoW.Flexi 的事务并发与可复用接口
把系统分区、一致性、地址翻译、启动和安全责任映射到芯粒接口,再沿 BoW.Flexi 四层协议分析宽度、ECC、并发、仲裁与测试。
芯粒化把片上连线变成跨裸片接口,也把原先隐含在单颗 SoC 内部的责任显性化:主存归谁管理,地址在哪翻译,一致性消息如何传递,哪个控制器能复位其他芯粒,安全启动怎样形成一个完整平台。AI Factory 规划芯粒生态时,系统角色、事务语义和物理传输需要逐层对齐。FCSA 负责系统组成与接口责任,BoW 家族提供传输选项,BoW.Flexi 则面向简单、低成本、可配置的芯粒连接给出具体协议栈。S059 pp.13–18,121–128 S063 pp.18–22
从系统分区推导接口责任#
FCSA 将 system 定义为支持同一个操作系统或 hypervisor 软件映像的硬件集合,并给出两类基础组成。Compute & Hub 系统把 Application PE 放在 Compute 1 芯粒,主存、系统级缓存和 I/O 放在 Hub;Compute Tile 系统则让 Compute 2 芯粒同时包含 PE、主存、系统级缓存和 I/O。前者利于把计算工艺与 I/O、内存能力分开复用,后者使扩展单元同时携带计算与内存资源。S059 pp.18,27–33
这两类分区会形成不同的通信压力。Compute & Hub 的计算到主存路径跨过 Compute–Hub 边界,Hub 的端口和带宽需要承接多个计算芯粒;Tile 中的本地访问可留在 tile 内,跨 tile 访问则需要共同的物理地址图与一致性处理。FCSA 要求这两种系统的 Application PE 对共同共享的主存区域保持一致,所有系统可寻址内存可由各 Application PE 访问。如何实现缓存目录、容量和具体拓扑,则由更高层的设计与产品 profile 继续约束。S059 pp.14–15,30–33
扩展芯粒的分类进一步决定访问语义。Fully Coherent Device 带有自身 coherent cache,并对系统执行一致性访问;I/O Coherent Device 自身没有 coherent cache,但访问可与系统缓存保持 I/O 一致。地址翻译可以放在设备端、接收端或经远端翻译接口完成。一个用作推理加速器的第三方芯粒,必须先确定属于哪种角色,再选事务协议与链路容量。把这些决策写入采购接口,能够减少集成时才发现 DMA、翻译、缓存维护与中断模型不匹配的风险。S059 pp.18,50–70,96–108
FCSA 与 BoW 通过传输层组合#
FCSA 的一致性内存流量接口使用 AMBA CHI C2C 作为 Level 1 协议要求,用于传递内存访问、snoop 和 DVM 消息。相应 transport 在规范中仍标为待定义,UCIe streaming 和 OCP BoW 被列为选项。非一致访问、配置、系统控制等接口也分别拥有自己的协议与传输约束。S059 pp.123–133
因此一套芯粒设计可以同时满足 FCSA 的系统角色,并在不同接口选择不同传输。选择 BoW 后,还需说明其上承载什么语义、版本如何对齐、多个服务共享链路时怎样保证顺序与前进。BoW.Flexi 给出的 AHB/APB 桥接、配置与 Virtual Wire 是可用构件;完整 CHI C2C 一致性路径需要匹配的协议映射和实现。FCSA 的层级机制允许 design、profile 在基础规则上继续增加这些条件。S059 pp.14,121–128 S063 pp.18–22,99–105
观察下图从顶端总线向底端物理接口的四层路径:两端的 configuration 逻辑位于 Transaction 层,ECC 在 Link 层,PHY 只负责跨裸片传递位流。这样可以直接定位一个新总线桥需要改变哪一层。
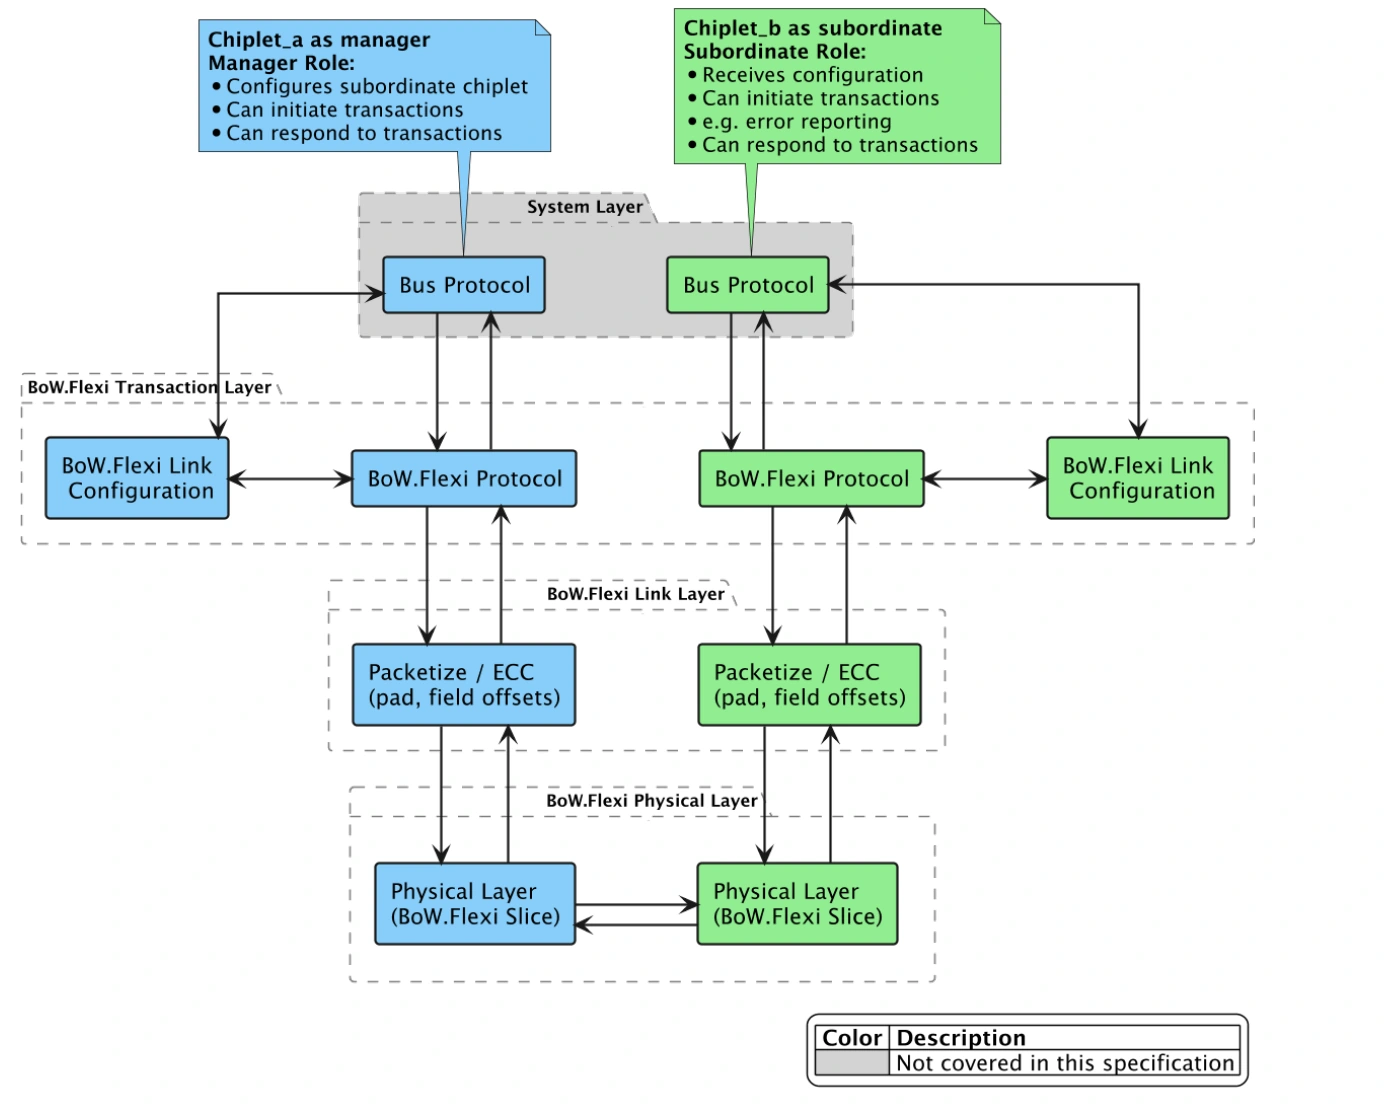
原图:S063,物理第 19 页,Figure 4.1,BoW.Flexi Layered Architecture。S063 pp.18–20
System 层翻译 AHB/APB 等总线事务,负责 ready/response 握手、posted/non-posted 区分、地址译码和 outstanding 策略;Transaction 层处理发出仲裁、配置和 Virtual Wire,将逻辑字段装成报文;Link 层加入 ECC 与补齐;Physical 层用源同步时钟、Frame 和数据 lane 传输。每一层的责任都能对应到独立验证目标:总线层看事务完成,事务层看仲裁和字段,链路层看错误处理,物理层看时序裕量。S063 pp.19–20,35–43
可变宽度节省接口成本,也改变有效吞吐#
BoW.Flexi 每个方向是一条单向 slice,由转发时钟、Frame 及数据线组成;两个方向共同组成接口。链路以 x1 数据模式初始化,再由预先指定的 manager 配置 subordinate 的收发 lane 数、地址宽度、ECC 等。新数据在时钟上升沿发送,接收方在下降沿采样,Frame 的起落标记报文范围。S063 pp.18,30–31,38–43
数据 lane 数可在 1–128 之间以 1 位递增,两个方向可不对称;PHY 与 Link 层之间的内部并行数据宽度则取 1–128 的 2 次幂。默认工作电压为 0.75V,所有实现需在 0.65–0.90V 默认范围内工作,另有面向低功耗或旧工艺的可选范围。S063 pp.38–39 这适合把低带宽传感、控制或辅助芯粒以较小接线成本接入系统,也允许某一方向拥有更宽的数据路径。
宽度和频率给出原始容量,真实事务还消耗命令、地址、size、可选字段、ECC 和 padding。可选 ECC 每个 128 位码字承载 120 位数据及 8 位校验;首码字的 120 位中还包含 3 位 CMD,留下 117 位 payload。未满码字先零填充计算 ECC,然后将实际发出的报文补齐到 PHY beat 宽度的整数倍,接收方依据 Frame 和有效位数恢复边界。S063 pp.35–37
以本文构造的吞吐估算为例,若一个方向采用 16 lane、1Gb/s 每 lane,原始带宽为 16Gb/s;长报文只考虑 120/128 的 ECC 编码率,剩下约 15Gb/s,之后还要扣事务字段与末尾补齐。短配置报文的占比损失更大。相同链路上,128B 连续数据与一个小寄存器读取的有效带宽会有明显差别。因此 RFQ 中应同时给出事务大小分布、读写比例和延迟,而非只列总 lane 数。
outstanding 策略决定链路如何服务计算#
BoW.Flexi 将命令分成三个 class。Link Interface 包含 Configuration/Error 和 Virtual Wire,由 Transaction 层管理,单个配置读取只能有一个 outstanding。普通 System Interface 的总线请求和响应由 System 层管理单 outstanding;AHB 桥可保持 HREADY 为低,等响应后完成总线事务。可选 Advanced System Interface 通过扩展命令承载自己的 credit 或多 outstanding 策略,以独立端口把 opaque 位流送到 Transaction 层仲裁。S063 pp.30–34
单 outstanding 容易实现,但长往返时延会降低读取利用率。以一次请求返回 D 字节、总事务往返时间为 L 为例,在没有其他可重叠请求时,吞吐上限约为 D/L,即便物理链路尚有空闲也会等待响应。Advanced class 可以让设计在 System 层引入多请求并行,但随之增加 ID、缓冲、流控、响应重排和死锁分析工作。这些代价应与目标业务相匹配:辅助控制链路通常偏向简单,持续数据面则需要更细的并发预算。
三个 class 共享链路时,规范要求仲裁无死锁、所有持续 ready 的源在有界报文数内得到服务;分级 round-robin 是给出的实现示例。普通 System 响应由上层优先于新请求呈现,Advanced 与其他 class 之间则没有跨 class 的顺序保证。S063 pp.32–34 这意味着系统设计还要明确哪些操作需要 fence,以及错误上报与配置流量在压力下如何及时完成。
管理、安全与测试进入同一套芯粒接口#
存储扩展又有独立协议模式。BoW.Flexi for Memory 通过 protocol_mode 改变命令语义,保留配置/错误机制,并可让数据路径以 half-duplex 方式复用收发,使用总线 turnaround 配合读写;bank management 与数据传输则可交错,内存模式也允许流水请求。S063 pp.106–113 这说明芯粒传输需要围绕目标媒体定制:控制总线的单 outstanding、内存的流水语义,以及 HBF 的 AXI-over-UCIe,是不同接口组合,系统描述应保留各自配置和完成条件。
一个可复用加速芯粒的接口描述可以按实例具体展开。假设某 Compute & Hub 系统增加一个不带 coherent cache 的计算引擎:应用提交命令后,引擎通过 I/O coherent 路径读取 host buffer,并把完成中断返回 Application PE;设备配置、系统控制和安全启动分别沿其对应接口进行。设计团队需要在每个交接点写清地址属性、翻译责任、可见性和中断目标,再决定哪些服务共享一个物理传输。FCSA 明确指出,共享 transport 可能改变延迟、事务顺序与死锁规避条件,因此共享后的总线行为需要重新验证。S059 pp.18,121,123–128
在这种配置中,Virtual Wire 可承接短的状态变化,配置命令用于发现和初始化,System bridge 承接总线事务。若高带宽 DMA 与控制报文共享同一 Flexi 链路,bounded-service 仲裁保证每类持续就绪流量获得机会,却仍需按最大报文长度、仲裁轮次和桥接等待计算最坏响应时间。一个很长的数据包会占据物理传输直到 Frame 结束,控制面所需时限可能要求更短分片或专用接口。这样才能把“不会饿死”继续落实为可接受的控制延迟。S063 pp.18–20,30–38
链路加宽还改变封装和测试规模。对 x128 数据方向,数据 lane 周围的电源地分布、耦合长度、邻线切换模式与电源瞬态都可能消耗电压和时序裕量;单线理想误码目标无法直接替代整组信号的验证。规范给出的系统级近似为 BER_system=N_data·BER_per_wire,并将同时开关噪声、串扰和供电压降列入多 lane 分析。S063 pp.62–66 工程上可以从窄接口测试载具获得模型,再在目标宽度、负载和封装布线下复测,分别记录每线裕量与系统重试或纠错事件。
FCSA 系统控制框架用一个 primary controller 协调多个 secondary,覆盖复位、初始化、时钟、功耗、温度和遥测;安全框架则由 primary Trusted Security Agent 承担平台 RoT,组合其他芯粒的安全启动状态与证明。在 FULL 级别要求中,安全代理的初始启动优先于同芯粒系统控制器。S059 pp.117–120 这些路径需要在主数据面尚未完全工作时建立,规划时可保留独立的启动与管理传输。
BoW.Flexi 提供配置读写、错误寄存器、Virtual Wire、唤醒及测试入口。PRBS31、BERT、晶圆和封装回环用于检验物理接口;规范的 10⁻²⁵ 孤立单线 BER 是基于电压与时序裕量分析的设计目标,多 lane 下还需计算串扰、同时开关噪声和 IR drop。S063 pp.49–66 将晶圆筛选、封装测试、上电发现、压力下错误恢复连成一个流程,才能让可复用裸片在不同系统中保留可诊断性。
封装内的选择还会影响外部高速网络。HBF 采用 UCIe streaming 承载 AXI,显示了大带宽存储芯粒可以对主机接口作专门约束;板级 retimer 标准 footprint 则把可替换性继续延伸到机架连接。S060 pp.25–29,78 S064 pp.7–9 高带宽闪存与光电链路分别展开这两个边界。芯粒体系的真正复用单位是“功能、接口、管理和测试都能共同成立”的组件,物理接通只是这套契约的一部分。
