高带宽闪存的主机与媒体协同
HBF 的基底裸片、独立通道、页面调度与生命周期管理
从 HBF 的主机、基底和 NAND 堆栈重建读写路径,说明 64B 请求与 4KiB 页、通道交织、可选 SRAM、刷新和容量退役如何影响模型服务。
高带宽闪存 HBF 将大容量 NAND 堆栈放到 xPU 附近,以多个独立主机通道并行读取,服务容量大、读占主导的模型数据。这个设计把传统存储层的一部分调度责任移到主机:模型如何跨通道分布、如何凑齐媒体页、何时刷新和重写、如何处理容量退役,都直接影响应用带宽。其基础是基底裸片在高速主机接口与 NAND 媒体之间完成协议、调度和纠错。S060 pp.15–26,112–123
基底裸片把接口并行变成媒体并行#
HBF 组织包含三部分:Core die 由 NAND 裸片堆叠构成,Base die 位于底部并管理流量,TSV 在基底与媒体之间传递信号。规范的容量示例采用 16 个 NAND die、最多 16 个独立主机通道,单堆栈为 512GiB;每个主机通道访问自己的媒体集合,各通道独立时钟,通道之间无需同步。S060 pp.15–19
下图应沿右向左阅读:主机请求经过 UCIe PHY 与 BaseDie Controller,进入 NAND-side PHY 和媒体堆栈。底部的 TSV repair、IEEE 1500、DA port 与 BIST 显示,基底还承担封装修复、调试与测试;它既是高速数据路径,也是媒体生命周期的控制节点。
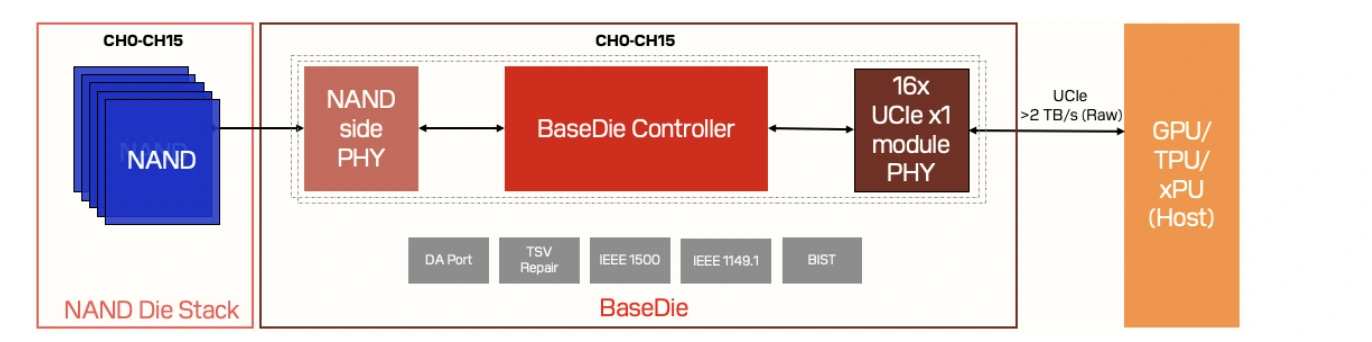
原图:S060,物理第 17 页,Figure 1,Base Die High-level Organization。S060 pp.17–19
每个主机通道包含独立 UCIe 链路,mainband 数据宽度为 64 位,并有 1 位 sideband 路径。基底的 UCIe controller/PHY 对接 xPU,Base Die Controller 管理 host command、core command、ECC、读写擦状态、NAND 初始化、坏块与 TSV 冗余,并安排从 core 到 host 的数据传输。主机全局地址先分配到各 UCIe 本地通道,再由基底映射到 bank、die、block。S060 pp.18–24
独立通道是一条重要的扩展边界:某通道收到的请求无法访问其他通道媒体。主机必须在加载模型时把可并发访问的数据展开,随后用足够多的 outstanding 读取同时推动这些通道。对主机而言,总容量是多个本地线性空间的组合;高带宽来自对这些空间的协调使用。
主机接口峰值需要媒体与协议一起供给#
规范表 2 的计算以每 lane 32GT/s、每通道 64 位、16 个通道为基础:每通道原始 256GB/s,总原始 4096GB/s,按 75% AXI link-layer 效率得到每 cube 有效 3072GB/s,即十进制 3.072TB/s。表 4 将这一值列为最高 speed grade 的最大用户带宽;文中特征列表另有 3.072TiB/s 字样,本文沿用表 2、表 4 可复算的十进制口径。S060 pp.15–16
这些是规范的接口计算与能力目标。应用接近该带宽,需要通道、bank 和 die 级并行与其相匹配。通道内可配置 1、2 或 4 个虚拟 AXI 接口,容量平均分配给各虚拟接口,主机可以按 64B 的倍数选择交织粒度。规范给出的四 AXI port 示例中,所有接口在 4KiB 交织下同时返回,能够最大化读取带宽。S060 pp.16,22–24
UCIe 采用 streaming protocol 和 latency-optimized 256B Format 6 flit。AXI 消息在协议层打包为 flit,并要求各 AXI channel 独立流控,减少不同通道之间的阻塞;HBF 还基于 AXI-over-UCIe 的 HBF profile 加入同步、用户位、ID 与错误消息。S060 pp.25–29,78 这条路径上的带宽会同时受 flit 效率、请求深度、媒体 sense 与返回数据调度约束。封装内接口体系可结合芯粒系统与传输分层阅读。
64B 主机读与 4KiB 媒体页之间有一个工作集#
HBF 主机读以 64B 为粒度,地址需 64B 对齐,单次读范围最多 4KiB,且不跨 NAND 页边界;媒体页大小为 4KiB。不同 AXI ID 的读取可以乱序完成,同一 ID 维持顺序;同一 bank 的 sense 请求严格排序。每个 bank 支持至少容纳两个页面的 cache buffers,命中且不违反顺序时由基底立即返回。S060 pp.15,56–57
这形成一个介于媒体与主机之间的页缓存工作集。若应用连续取一个页面中的多个 64B 切片,首次 sense 之后可从 cache buffer 返回后续片段;若在同一 bank 上交错访问多个页面,较早页面可能在读取完成前被后来的页面驱逐。规范建议在发出会驱逐首个页面的第三个 4KiB 地址前,先读完首个页面。S060 p.57
以本文工程算例说明:某算子需要一组相邻的 4KiB 权重,将其拆成 64 个 64B 读请求并安排不同 AXI ID,可与通道内并行配合;若只读取这个页面中的一个 64B 后就切到下一个不相关页面,主机有用字节仅占媒体页的 1/64,即 1.5625%。具体媒体操作与缓存命中会影响真实放大系数,但这个比例提示了布局方向:将同时使用的权重、scale 与索引尽量组织进共同的读取单元。低精度表示降低数值字节数后,也应重新检查这种页内利用率。
普通读可由基底聚合调度,batch-read hint 则向基底传递批次信息,使调度无需继续等定时器。对图执行器而言,这意味着编译期已知的一组权重访问可通过批次语义暴露给设备,而零散、未知依赖的读取更依赖缓存与实时排队。评估指标应同时包含连续页带宽、稀疏小读延迟与混合访问下的尾延迟。S060 pp.56–57
写入路径把 NAND 顺序约束暴露给主机#
媒体写以完整 4KiB 为单位,基底先收齐数据,再写入 Core die;host write 为 non-posted,完成响应在媒体写入后返回。主机开始一个 4KiB 写入后,需在初始化时配置的超时内交齐整页;同一 NAND block 内页面需顺序写入,可同时操作多个不同 block。page 0 写入会触发对应 block 自动擦除。S060 pp.58–60,121–123
这适合以批量加载和重复读取为主的权重层:加载阶段按通道和媒体顺序写入,运行阶段展开多通道读取。频繁小更新的可写状态则需要主机缓冲合并、独立布局或其他内存层承接。若一次 4KiB 写仍在收集部分数据,此时同地址读命中已到达部分可以返回,命中尚未到达部分则产生指定错误。应用层的发布顺序与完成语义必须匹配这个行为。S060 pp.58–59
可选 scratchpad SRAM 提供另一条路径。各 UCIe 通道拥有独立 SRAM 空间,由主机管理内容和有效性,支持高优先级、低延迟读写,可用于临时激活或层间缓冲,掉电后数据丢失。SRAM 写为 64B 粒度,绕开 NAND 整页收集和编程过程。其容量及支持情况从产品配置获得。S060 pp.16,57–58,116 分层设计由此可包含 HBM、HBF NAND、可选 SRAM 以及主机缓存,各自承接不同访问频率与可变性的数据。
主机管理让大容量伴随可控维护#
0.7.0 基底裸片规范的可靠性章节还给出上电 85°C 条件下 24 小时数据保持的规格,以及 0–105°C 的结温工作范围;endurance 与 read disturb 参数由具体产品提供。设备寿命按十年或 endurance 指标达到上限两者先到者界定,host 利用最大和平均 program/erase cycle 信息管理剩余寿命。S060 p.106 因此容量层需要持续的副本、刷新和寿命监控,长期模型母本可保留在持久存储中,HBF 承接计算附近的可重建工作集。
温度响应分为 normal、light throttling、severe throttling 与 shutdown。轻度节流可降低速度;严重节流通过 CATTRIP 报警,并在处理在途命令后撤销 AXI Ready、停止继续发放 credit,形成对主机的背压;温度继续上升则关闭设备。RTT、LTT、STT 阈值定义恢复、轻度与严重节流的迟滞关系。S060 pp.106–108 应用看到的带宽下降因此可能来自热控状态变化,采集链路应将温度、credit、错误和通道吞吐放在同一时间线上。
HBF 的磨损均衡可以由 host/xPU 负责,也可采用产品特定的 Base-die-driven 方案。规范提供 zone remapping:每通道分为等容量 zones,主机读取或维护各 zone 的 program/erase cycles,再在热区和冷区之间交换映射。交换前必须保证相关数据已无效,并停止后续读取。HBF 通过映射改变未来写入位置,现有有效数据的搬移与垃圾回收需要主机软件组织。S060 pp.117–118
读取也参与寿命管理。媒体 retention 与 read disturb 要求定期刷新,规范在软件指南中给出通常 24–48 小时的刷新示例,具体间隔与最大读取次数由产品可靠性参数确定。把刷新与在线任务交织时,同一 die 的刷新与读请求要错开,以控制额外延迟。S060 p.118 规划一层大容量权重缓存时,可保留可重建的备份副本,按通道分批刷新,并把维护带宽从峰值带宽中预留出来。
错误返回进一步连接设备与主机。高可纠错错误可返回有效数据并要求刷新;UECC 可能要求重试或从备份重建;不可恢复的 block、bank、die、channel 会报告退役粒度,主机更新可用容量与分配图;临时恢复状态则要求等待后再访问。S060 pp.59–60,118–123 HBF 的安全功能也以产品选项给出,包括上电数据失效化和 sanitize,需与模型副本管理及设备退役流程一并选择。S060 p.124
以模型访问模式安排容量与带宽#
模型压缩还会改变媒体调度。OFP8 的 E4M3/E5M2 让每个数值占 1B,块 scale 和索引随布局加入;同一层权重的总字节减少后,既可在固定容量中保留更多模型,也可在同样通道带宽下更快地完成读取。S062 pp.10–16 若把一个专家的热权重集中在少数通道,压缩带来的容量收益与通道负载不均会同时出现。可将大矩阵按读取块跨通道交织,把小而频繁的元数据放在易命中的缓存或可选 SRAM,并记录每个张量的真实页占用,保持数值布局与媒体布局一致。
当容量池进一步跨多个计算节点,HBF 的封装内 UCIe 路径与远端内存访问路径具有不同延迟、协议和故障条件。开放光子架构以更远的高带宽域讨论 KV cache、expert weights 等工作集的可达性,但主机依旧需要决定哪些状态留在本地、哪些可分布或重建。S056 pp.54–61,190–192 因此可先把 HBF 定位为节点附近的大容量层,再用实际读粒度、复用距离和任务依赖判断远端扩展。吞吐预算中分别列出本地页缓存、媒体 sense、通道并行和网络传输时间,可以避免容量指标遮蔽关键路径。
单模型服务的示例把 QKV、输出投影及前馈层权重按 4KiB×N×16 通道展开,其中 N 取决于每通道可并行 bank/plane 资源。读取时尽量在一次媒体读周期内启动这组页面,持续向 xPU 供给数据。S060 p.125 因此 HBF 的重要软件资产是“模型到通道和页面的映射”,它与调度器选择 batch、专家放置和请求并行度共同决定有效带宽。
多模型服务还可以采用独占通道,减少不同模型在同一媒体资源上的碰撞,代价是单模型无法同时使用所有通道的总带宽。规范的 KV cache 例子进一步允许按通道分区,将写入模式不同的权重和 KV 分开:均匀分组便于磨损均衡,非均匀分组按模型大小分配容量。S060 pp.126–130 选择标准由并发服务方式决定:单模型极致带宽、多模型隔离和容量利用率,分别对应不同的通道占用与重写计划。
通道分区也会改变压缩后的收益。低精度计算篇用同一个专家 tile 演算了 FP8 数值加 scale 如何从两页压进一页,再把 32 个 tile 分到 16 个独立通道,使简化冷读轮数从四轮减到两轮。若为了多模型隔离将该专家固定在少数通道,它仍保留容量和页数收益,并行读取时间则取决于获配的 bank 与通道。模型放置由此要同时回答三件事:一次执行真正用到哪些页,这些页能否并发,以及刷新、更新和其他模型会占用哪些相同资源。S060 pp.56–57,125–130
