从 Pod 组到开放集群的端口扩展
以 OPG-128 与 XOC-1k 复算 leaf、spine、breakout 和超售
核算 OPG 的计算、存储和管理接入,比较两代 leaf 配置,重建 1,024 xPU 的共享 spine 预算,以及小集群、双平面和继续扩容的约束。
从 Pod 组扩展到集群,需要同时扩展计算资源和共享连接。OPG-M 固定一组可复用的计算、leaf、存储和管理构件,XOC-N 负责把这些构件接成完整系统。两层接口的关键量是每个模块向上交付多少条链路、占用多少共享端口,以及发生故障或维护时哪些作业受影响。只有把这些量算清,模块复制才能转化为可预期的集群容量。S052 pp. 6–12 S050 pp. 6–10
OPG 的计算规模与资源边界#
早期 OPG-128 实例采用十六台八 xPU 服务器。每台配置八个单口400GbE加速器 NIC,另外每个 CPU 配置双口100GbE NIC,分别进入 SO-C 和 storage;带内管理使用25GbE,BMC 接1GbE带外网络。128颗卡因此形成128条400G后端链路,同时存在32条100G CPU生产链路和32条100G存储链路。设备规模相同,几类链路的通信对象和上行预算各自独立。S052 pp. 14–17, 26–39
OPG 中还放入五台存储服务器和两台 metadata server。存储服务器示例有24个 E3.S NVMe 槽与四个400G NIC;metadata server 有两颗高频CPU、1TB DRAM与两个400G NIC。metadata 管理请求和文件共享的组织工作,bulk data 由数据服务器承担。将这两类服务器连同计算节点一起纳入模块,能够在复制计算单元时同步复制数据服务的接入能力。S052 pp. 15–16, 36–39, 53–55
这里的 pod、OPG 和 cluster 有不同作用。Pod 或小型 xPU-node 指共享 scale-up 域的计算系统,OPG 把一个或多个此类系统连同支撑资源组成扩展模块,XOC 再提供跨模块的共享层。早期实例采用空气冷却和约20kW/rack的冷却设计条件;后续训练 RA 仍以八 xPU 机箱为计算构件,将网络设计复用到不同机架密度。项目选择需要把“计算域多大”和“每柜放多少构件”分别写清。S052 pp. 8–12, 54–55 S048 pp. 14–17
同一 OPG 的两种 leaf 实现#
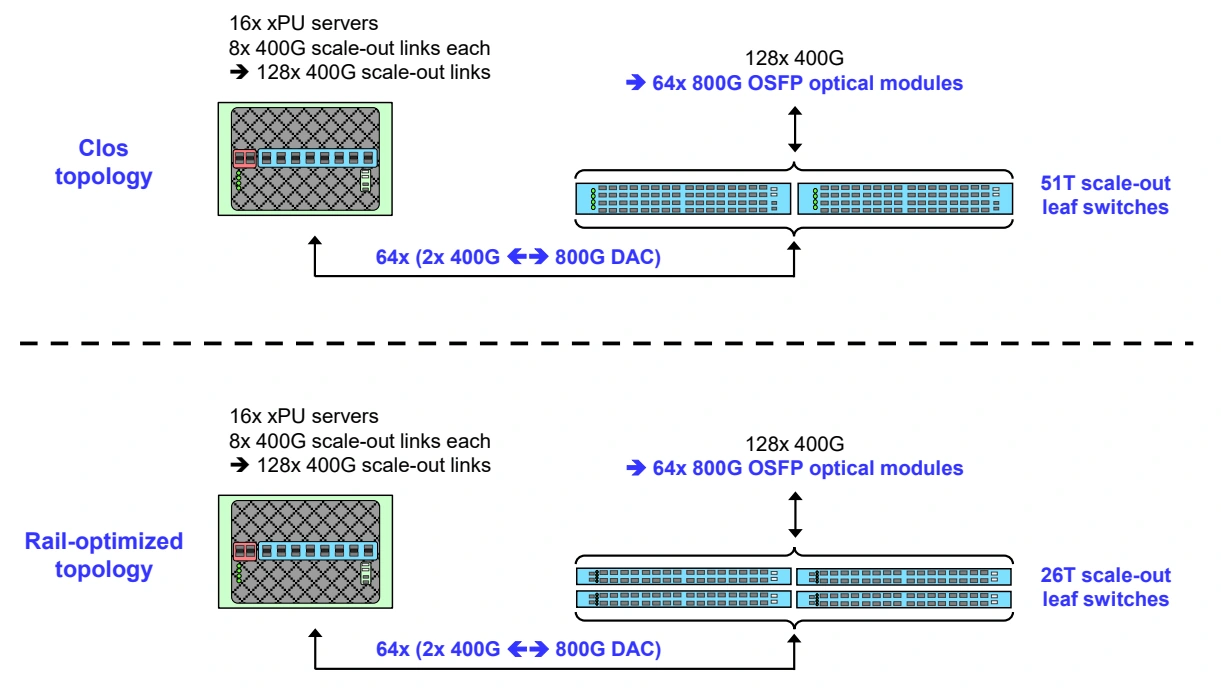
早期设计为 OPG-128 提供两种后端接线。单归属 Clos 使用两台51.2T leaf,每台接八个服务器的全部八条 NIC;rail-optimized 使用四台25.6T leaf,每台接十六个服务器中的两个 NIC 亲和索引。两种方案都向上交付128条400G链路,服务器侧也都是128条400G,区别来自 leaf 容量与 NIC 分组方式。S052 pp. 27–33
原图上半部是两台51T leaf,下半部是四台26T leaf。阅读时应对照左右两端的128×400G:服务器总接入带宽与模块总上行相同,而 leaf 台数和同交换机内的通信伙伴发生了变化。
原图:S052,物理第27页,Figure 10,Lowell D. Lamb 等/OCP,CC BY-SA 4.0。
以单归属方案复算,一台64×800G leaf 有32个物理端口向下、32个向上。各端口拆成2×400G后,向下64条400G承接八台服务器,向上64条400G提供相同的25.6Tb/s单向总速率。两台 leaf 合计向下与向上各51.2Tb/s。四台25.6T rail leaf 则每台向下32×400G、向上32×400G,全模块预算一致。这里所有带宽按相同方向相加,800G物理笼口与400G逻辑端点分开计数。S052 pp. 17, 27–33
训练 RA 的 rail 与单归属比较统一采用51.2T leaf,因此128颗卡时两种接线都可用两台 leaf;每台 rail leaf 承担四个亲和索引。比较时固定交换容量,才能单独分析下行分配改变的局部性。两份资料的配置条件可以并存,设备清单应注明 leaf 芯片容量、breakout、rail分配和上行比例。S048 pp. 20–25, 29–35
XOC-1k 把模块上行变成共享交换容量#
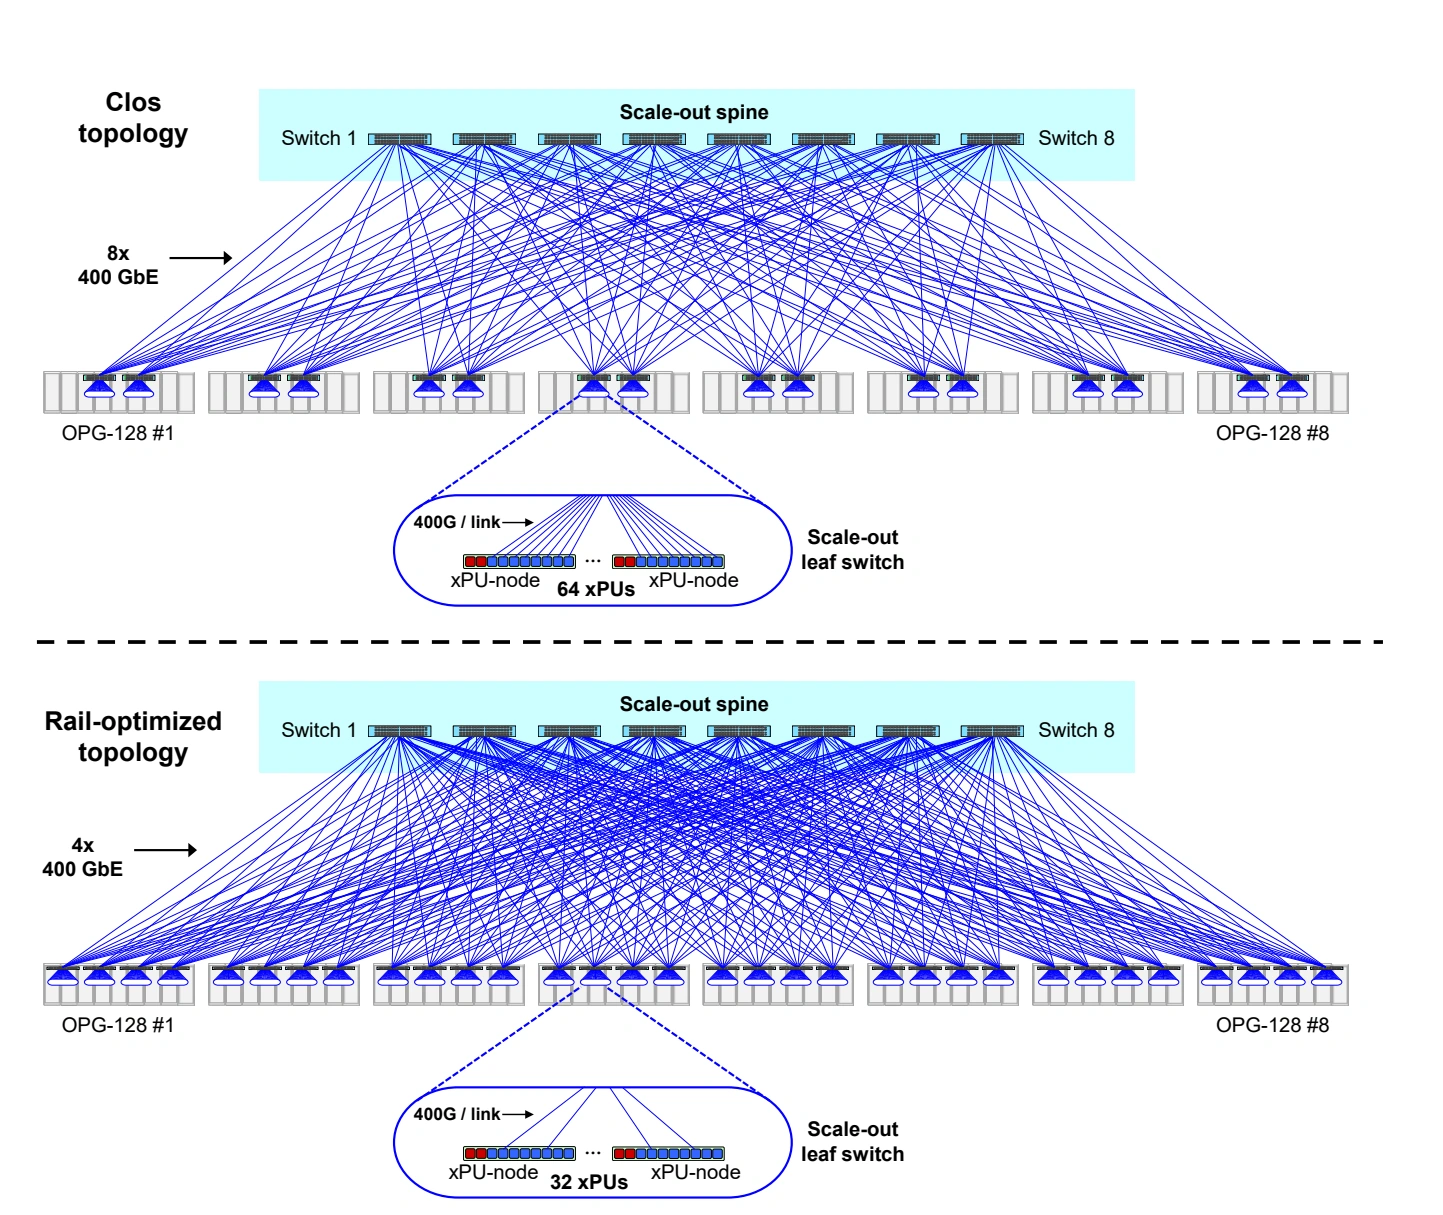
八个 OPG-128 合计1,024颗 xPU、128台服务器。单归属方案共十六台51.2T leaf,接到八台51.2T spine。每台 leaf 的64条400G上行均分给八台 spine,即每对 leaf—spine 有8×400G。每台 spine 接十六台 leaf,消耗 个400G逻辑端点,恰好占满64个双400G物理端口。S050 pp. 22–25
rail 方案将 leaf 换为三十二台25.6T设备,每对 leaf—spine 使用4×400G,同样满足 个400G端点。每个 OPG 向上仍是128条400G,八个模块总共1,024条。共享层的总接入容量来自这组端口守恒,与计算模块采用哪种接线分别计算。S050 pp. 23, 33–34
下面原图应先数 OPG 内的 leaf,再看每对 leaf—spine 的8×400G或4×400G标签。上、下两种实现共享八台 spine,但 leaf 数量与单对连接的并行链路数不同;这些参数一起维持总预算。
原图:S050,物理第23页,Figure 5,Lowell D. Lamb 等/OCP,CC BY-SA 4.0。
用速率比定义超售,用端口图解释扩容#
超售比应以同一 leaf 的服务器侧总速率除以上行总速率计算:
上例为 ,即1:1。作为本文变体,若保留全部下行、将上行减至32条400G,超售比为2:1。是否出现作业等待还取决于真实跨 leaf 流量、流分布和同时活动的租户;端口对称提供容量基线,局部性决定这些上行会被使用多少。S049 pp. 13–17 S048 pp. 23–25
共享层扩容需要分别检查各网络。早期 XOC-1k 的 scale-out spine 与 SO-C spine 已占满端口,继续增加 OPG 必须增加交换资源、调整 leaf—spine映射。带内管理也接近其示例的端口预算;存储共享层的剩余容量则要按采用的实际接线复算。这样,扩容计划可以明确哪些设备随模块线性增加,哪些需要在某个阈值处增加一级共享资源。S050 pp. 55–57
小集群还有另一条构型:当全部128颗 xPU 留在同一 OPG、无需外部后端 spine时,一台51.2T交换机可以把128个400G逻辑端点全部用于下行,承接十六台服务器;原来预留给上行的端口转给计算节点。存储仍需连接 head-end,管理也仍有独立路径。后续扩容要重新分配上行,项目应在初始方案中选择“紧凑独立单元”或“保留模块扩展接口”。S052 pp. 47–51
将上行接口拆为可施工的连接坐标#
OPG/XOC给出的connection map同时包含节点编号、NIC编号、交换端口和breakout分支。一个800G OSFP物理端口可以承接两个400G逻辑端点,因此端口号相同的两行仍可能分别对应不同NIC。跨模块光链还要区分交换机端口、光模块的两个400G接口,以及远端端点。设备清单、光模块清单和逻辑链路数量分别计数,施工与软件验证才能使用同一份连接事实。S052 pp. 28–33 S050 pp. 24–25
以一个单归属OPG-128为本文核算例,服务器侧128条400G连接用64根双400G breakout DAC接到两台leaf;向上128条400G光链,在模块侧占64个双400G OSFP模块,spine侧另有对应光接口。线缆、模块和链路的数量关系由端点形态决定。若把其中一段改成800G原生链路,端口radix和每对交换机的并行链路数都需重新安排,保持总速率相同还不足以保证原有接线表可复用。S052 pp. 11, 18–20, 27 S050 pp. 9, 22–24
管理网也具有同样的端口守恒。OPG内十六台计算节点、五台存储和两台metadata各接25G带内端口,共23条、575Gb/s,下行对应六条100G上行。带外侧则连接服务器、交换机和三十六个PDU,示例共64条1G端点,再分配七条10G上行。节点扩容可能先耗尽管理或配套服务的端口,因而完整模块接口表应把这些链路与后端并列。S052 pp. 40–46
共享head-end的容量又有另一种增长规律。用户入口跟并发客户端和数据装载有关,scheduler跟作业与资源对象数有关,镜像仓库跟启动风暴和版本分发有关,monitoring跟设备规模和采集频度有关。XOC设计为这些角色安排不同连接并推荐关键服务多实例;规划时可以保持角色不变,分别估算实际业务驱动量,再配置共享资源。S050 pp. 10–14
这也影响小规模部署的裁剪。减少OPG后,spine和客户端服务可随需求缩减,关键管理角色仍需保留满足可用性的实例。增加OPG时,后端上行、带内分发、存储恢复和带外终端分别越过自己的容量阈值。按照每类接口定义扩容触发点,比用一个总卡数阈值管理全部共享资源更容易维持可解释的性能与恢复路径。S050 pp. 56–57
布线介质与设备选址还会改变模块实施方式。训练RA指出,在八台服务器集中于一个液冷机柜的形态中,单归属leaf的64个下行刚好服务整柜,可利用短距离DAC/AEC。较大的rail域把服务器分散接到多台leaf,服务器侧连接更常跨机柜,可采用光纤;leaf若集中靠近spine,交换层之间又可能利用短线。可复用的逻辑拓扑因此应附带现场距离与线缆路线,按实际布局选择介质。S048 pp. 36–37, 43
将两个plane配置成独立逻辑网络时,线缆路径和patch区域也应分离,以降低相关失效。带外网络继续提供硬件恢复,控制器、存储与客户端入口则按各自可用性策略部署。本文据此将模块边界同时标记为采购单元、leaf层故障域和维护分组;调度仍以实际首跳连接判断性能局部性。几个边界在设备图上对应清楚,运维人员就能知道维护一个模块会影响哪些任务和哪类共享服务。S048 pp. 43, 51–52 S050 pp. 11–14
后续参考架构把构型与运行方式解耦#
训练 RA 的单平面400G基线给出 XOC-256 的4leaf/2spine、XOC-512的8/4和XOC-1024的16/8。相同总规模可以由不同 OPG 组合构成:正文以八个OPG-128举例,附录也列出两个OPG-512组成XOC-1024。模块选择影响资源管理与放置边界,最终交换容量仍要由整个 fabric 的端口表闭合。S048 pp. 20–25, 72–75
双平面进一步增加一个独立维度。每个GPU亲和NIC的两个端口分别进入两个 fabric:2×200G维持400G聚合速率,每平面128个200G下行允许更大的同rail域;2×400G则提供800G聚合速率,每平面仍是64个400G下行。以128服务器、八rail、2×200G为本文复算例,每平面需要 台leaf,两平面共十六台;交换机数应按总端口需求和每平面口数计算。运行时还需验证collective如何使用双平面,以及停掉一平面后剩余带宽能否承载任务。S048 pp. 31–43
从结构设计转成可运行集群,最后一步是让接线坐标、租户放置和生命周期操作使用同一套身份。连接表确定 NIC 与端口,Wiring CRD 表达实际拓扑,调度标签表达首跳域,遥测保留租户、设备、端口和方向。这样,一次链路故障可以追到受影响的rail、并行组和作业,扩容也能被核验为真实增加了哪一段容量。S048 pp. 25–28, 48–54 进一步的放置计算见拓扑放置与性能建模,传输与运行参数见训练 Fabric 的流量闭环。
