低精度计算的表示、缩放与数据路径
从 OFP8 数值边界连接到累加、模型布局和跨卡通信
拆解 E4M3 与 E5M2 的精确值域、舍入和溢出行为,推导缩放粒度、归约策略、存储页利用率与通信压缩如何共同决定有效吞吐。
AI Factory 的低精度设计同时改变三件事:乘加阵列每周期处理的数据量、存储层承载的模型容量,以及芯片之间必须搬运的字节数。只有把格式、缩放、累加和数据布局放在同一条执行路径里,8 位表示的收益才会落到有效吞吐。OFP8 给出了这条路径最底层的公共契约:两个精确的二进制交换格式,以及从较宽浮点格式向它们转换的行为。S062 pp.10–15
用指数预算换范围,用尾数预算换局部精度#
OFP8 定义 E4M3 与 E5M2。两者均有一个符号位,余下七位在指数和尾数之间分配。这里的 M 是不含隐含首位的 trailing significand。正常数的值为
其中 S 为符号位,E 为存储的有偏指数,b 为指数偏置,m 为尾数位数。非正常数使用 E=0,去掉隐含的 1,其值为
因此两种格式的差别可以沿同一条数轴理解:E4M3 在每个正常数 binade 内提供更密的点,E5M2 则覆盖更多 binade。binade 指具有相同二进制指数的一组数。S062 pp.10–13
| 性质 | E4M3 | E5M2 |
|---|---|---|
| 指数偏置 | 7 | 15 |
| 正常数最小、最大无偏指数 | −6、8 | −14、15 |
| 最大有限值 | 448 | 57,344 |
| 最小正正常数 | 2⁻⁶ | 2⁻¹⁴ |
| 最小正非正常数 | 2⁻⁹ | 2⁻¹⁶ |
| 覆盖的 binade 数 | 18 | 32 |
| 无穷 | 无 | 有 |
原表中值得同时看“最大正常数”和“NaN”两行:E4M3 把最高指数区间的大部分编码继续用于有限数,仅把尾数全 1 的两个符号编码留给 NaN;E5M2 保留最高指数区间表示无穷和 NaN。这个编码差异解释了 E4M3 的最大指数为何可以达到 8。
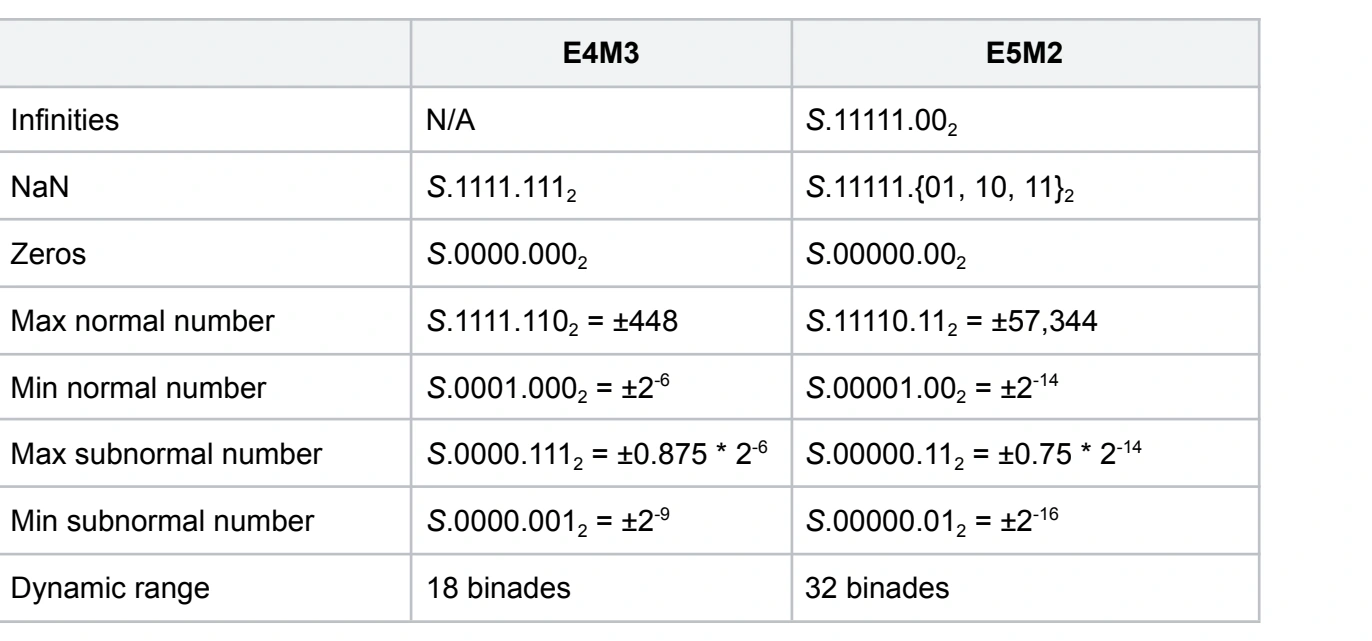
原表:S062,物理第 13 页,Table 2,OFP8 value encoding details。S062 p.13
在 [1,2) 区间,E4M3 的相邻正常数间隔为 1/8,E5M2 为 1/4;在不发生下溢、溢出的最近舍入中,半间隔误差上界分别是 1/16 和 1/8。这是依据格式公式得到的局部量化误差。它说明格式选择的工程顺序:先观察某个张量的动态范围与离群点,再判断在可接受的缩放下,三个或两个尾数位能否保留任务所需信息。权重、激活、梯度和中间归约值具有不同分布,分别设置表示策略更容易控制误差。
缩放决定有效值域落在哪一段数据上#
设原始张量元素为 x,选用正缩放系数 s,以 q=Q(x/s) 存储,读取时恢复为 x̂=sq。s 同时决定可表示的最大幅值和最小分辨率:E4M3 对应最大幅值 448s,最小非零量级 s·2⁻⁹;扩大 s 能容纳离群值,也抬高非正常区的绝对网格间隔,使小值更早面临下溢。正常区的间隔随 binade 改变,以二次幂调整 s 且数值仍处正常区时,相对精度可以保持。OFP8 的规范范围涵盖编码及转换,缩放系数的选择、表示和维护由计算实现另行定义。S062 pp.10–14
一个工程算例能看清这一点。若一个块的绝对最大值为 100,取 s=0.25,量化输入的最大值为 400,可落在 E4M3 有限范围中。对原值 x∈[1,2),此时 q∈[4,8),恢复后的网格间隔为 0.25×0.5=0.125;改成 s=4 后,q∈[0.25,0.5),恢复后的间隔仍为 4×0.03125=0.125。两种 scale 相差 16 倍,正常区这组数仍使用相同网格。
离群值的代价出现在有限指数窗口的边缘。若同一块混入幅值 1000 的值,原 s 会发生溢出;把 s 扩大到 4 可以容纳它,但原值 0.01 的量化输入会从正常数 0.04 变成非正常区中的 0.0025。两种 scale 对应的最小正数分别是 0.25·2⁻⁹=0.00048828125 和 4·2⁻⁹=0.0078125。更小的原值可能归零:例如 x=0.001 在 s=0.25 下可舍入为 0.0009765625,在 s=4 下则舍入为 0。按通道或更小块设置 s 可以隔离离群值对小值的影响,代价是更多 scale 元数据、更多索引,以及更复杂的内核与通信布局。此处的缩放策略和数值为本文推演,格式参数来自原规范。S062 pp.12–14
scale 的粒度也是数据管理粒度。若每 g 个元素共享一个 k 字节 scale,压缩后仅考虑数值和 scale 的存储量约为 n(1+k/g) 字节,而 BF16 数值占 2n 字节。以 g=128、k=2 为例,8 位数值连同 scale 为每元素 1.015625 字节,较 BF16 缩小约 1.97 倍。真实布局还要加入对齐、padding 和其他元数据。这一估算适合用于早期容量规划,接入实际算子后应按落盘或跨链路的真实布局计算。
转换边界会传播到内核和通信协议#
规范要求支持 Round-to-Nearest-Ties-to-Even,同时要求支持饱和与非饱和两种模式。对溢出,饱和模式输出带原符号的最大有限值;非饱和模式下,E4M3 输出 NaN,E5M2 输出无穷。输入 NaN 转换为实现定义的 OFP8 NaN;除 NaN 相关情形外,转换保留源符号位。S062 pp.14–15
溢出判断发生在按目的精度舍入之后,因此“超过最大有限值”与“发生溢出”存在一段边界区间。E4M3 最大有限值 448 的尾数最低位为偶,448<x≤464 仍舍入到 448;E5M2 最大值 57,344 的尾数最低位为奇,61,440 这个半 ULP 点会向上舍入,进入溢出或饱和路径。这些边界是规范修订中专门补充的例子。S062 p.16
落到实现,转换模式至少需要贯穿模型导出、运行时描述符、CPU 参考实现和设备内核。离线转换采用 SAT、在线转换采用 NONSAT,或通信两端把同一字节解释成不同 FP8 变体,都可能造成难以定位的异常。测试向量应覆盖零、最小非正常数、正常与非正常分界、448/464、57,344/61,440、无穷及 NaN,并记录读回结果。相比只检查随机分布的平均误差,这组边界更容易发现编码契约的错位。
点积的表示精度与归约精度分别设计#
以块矩阵乘为例,A≈sA·QA,B≈sB·QB,则 C≈sA·sB·(QAQB)。若 A、B 在各自归约块使用不同 scale,整个点积是多个带不同 scale 乘积的部分和:
这个式子揭示三类实现成本:低位乘法、局部归约,以及将不同尺度的部分和对齐后继续累加。OFP8 为交换格式标准,算术运算方式由硬件及软件栈定义。因此使用 FP8 输入时,规划仍需单独写清累加格式、归约顺序、缩放应用位置和输出转换时机。S062 p.10
从工程上,较宽累加器可降低长点积中的累计舍入误差,融合 scale 与计算可减少独立转换核的读写。然而融合也让不同设备之间的数值一致性更依赖内核约定。多卡归约尤其需要明确:在线路上发送 FP8 后由接收方扩大再归约,还是先归约再量化;每个通信分片是否携带独立 scale;重试时是否重用相同的量化状态。它们共同决定误差、通信量与复现性。
低精度收益沿存储与互连传递#
多卡通信可以进一步按“数值、元数据、归约状态”拆开预算。以本文构造的 256MiB BF16 激活块为例,数值元素数为 134,217,728;若按每 128 个元素带一个 2B scale,FP8 数值加 scale 共为 130MiB。在 400Gb/s、没有协议开销和竞争的单向路径上,传输时间从约 5.37ms 降到约 2.73ms。这是字节与带宽的除法估算,算子量化时间、打包和解包、链路利用率、重传需要随后逐项加入。若独立转换核的读写和同步超过所节省的约 2.64ms,通信压缩就需要与生产激活的算子融合,或改用更粗粒度的分片。
对于 collective,还要沿归约树核查 scale 的生命周期。一组参与者若各自使用不同 scale,交换的字节相同也不意味着可以直接按相同数值做加法;接收端需要恢复尺度,或使用约定的共同缩放。先求局部最大值再确定共享 scale,会增加控制通信和同步;各块独立 scale 可减少这种同步,却要求接收端保留更多元数据并处理不同部分和。这个取舍与普通点对点搬运不同,适合为 AllReduce、ReduceScatter 和专家 all-to-all 分别制定数据契约。
一个专家权重块如何缩短实际读取路径#
HBF 的主机读以 64B 为粒度,NAND 页为 4KiB;每 bank 至少有两个页缓存,缓存命中可直接返回,同 bank 的 sense 请求则依序进行。读取尚未完成时引入第三个页面,可能把先前页面驱逐。S060 pp.56–57 因而 FP8 的收益要从数值和 scale 的实际排布追到媒体页,再追到可并行的 bank。
取同一专家矩阵中的一个 tile,包含 3968 个元素,分成 31 个 128 元素块,每块附带 2B scale。BF16 数值占 7936B,落在两个对齐的 4KiB 页中;FP8 数值占 3968B,scale 占 62B,共 4030B,可以放进一个 4KiB 页,页内数值加 scale 的有效利用率约为 98.39%。按 64B 粒度读回,前者为 124 次请求、7936B,后者为 63 次请求、4032B,其中含 2B 对齐填充。这里假设整页对齐、scale 紧随数值存放,其他描述符由主机已有状态提供;这些容量与请求数为本文算例。S060 pp.15,56–57
这个布局减少了一次冷页读取。对比包含 4096 个元素的 tile:FP8 数值 4096B 加上 64B scale 合计 4160B,仍跨两个媒体页。主机有用字节已经缩小,NAND sense 次数却可能保持不变。将 tile 边界与 scale 一起装进页面,或让相邻 tile 连续复用已 sense 的页面,才有机会把表示压缩继续转成媒体访问压缩。
再把前述 3968 元素 tile 扩展到 32 个独立读取任务。假设主机均匀分到 16 个通道,每通道只使用一个 bank,开始时页面均未缓存;每轮每 bank 完成一个页面的 sense。BF16 的 64 页需要四轮,FP8 的 32 页需要两轮。主机返回的数据量同时从 32×7936=253,952B 减到 32×4032=129,024B。在暂不考虑 sense 与传输重叠的简化模型中,读取时间可写成
其中 R 是媒体访问轮数,t_sense 是该配置下每轮 sense 时间,D_host 为实际返回字节数,B_host 为可用聚合主机带宽。这个算例中的 FP8 同时减小 R 与 D_host;若 tile 全挤在一个 bank,或 scale 单独触发额外页读取,轮数就会改变。实际实现允许流水与更多 bank 并行,两个分量的重叠关系须由产品和调度确定。HBF 的独立通道、bank 顺序及两页缓存条件给出了这条推演的硬件依据。S060 pp.15–24,56–57
因此同一块专家权重有一条可闭合的路径:数值与 scale 决定页面有效负载,页面布局决定 sense 与缓存复用,通道分布决定并行轮数,返回字节和媒体等待共同决定读取时间。高带宽闪存的主机与媒体协同继续展开这条路径上的写入、刷新与容量管理。跨节点传输还会把相同字节变化传给光电链路与OCS 调度,并在完整路径上影响每 token 或每训练 step 的能耗。S058 pp.52–56 S056 p.145
