量子处理器的经典闭环与设施集成
作为异构扩展规划 QPU、实时纠错、日志和模态环境
从逻辑 QPU 的控制链重建经典计算与设施需求,区分异步任务、实时纠错和环境反馈,推导存储增长并比较不同量子模态的部署条件。
量子处理器可以作为 AI Factory 的一种异构扩展,复用经典计算、网络、存储和设施能力,同时引入由量子模态决定的环境与实时控制要求。规划的重点是为特定任务和设备建立完整的量子经典执行路径:应用作业如何进入 QPU,实时反馈在哪完成,校准与历史数据如何管理,设施怎样长期维持量子系统的工作环境。OCP 的量子集成白皮书围绕这条路径组织了参考架构和厂商部署案例。S061 pp.5–17,20–28
逻辑 QPU 是一个量子经典控制系统#
白皮书将 logical QPU 参考栈分为 real-time host、real-time interconnect、quantum system controller 和 physical QPU。物理 QPU 保存、操纵和测量量子态;controller 把数字指令转成微波、激光、光场或其他模态对应的脉冲;实时主机结合 syndrome、校准健康数据和逻辑指令决定后续动作。S061 pp.9–12
看下图时,应从左边经典计算进入 logical QPU,再沿中间的实时主机—控制器—物理 QPU 路径追踪反馈。最右侧 environmental control 包围的是物理运行条件;它持续支持 QPU 的稳定性,并与实时计算形成不同但耦合的控制环。
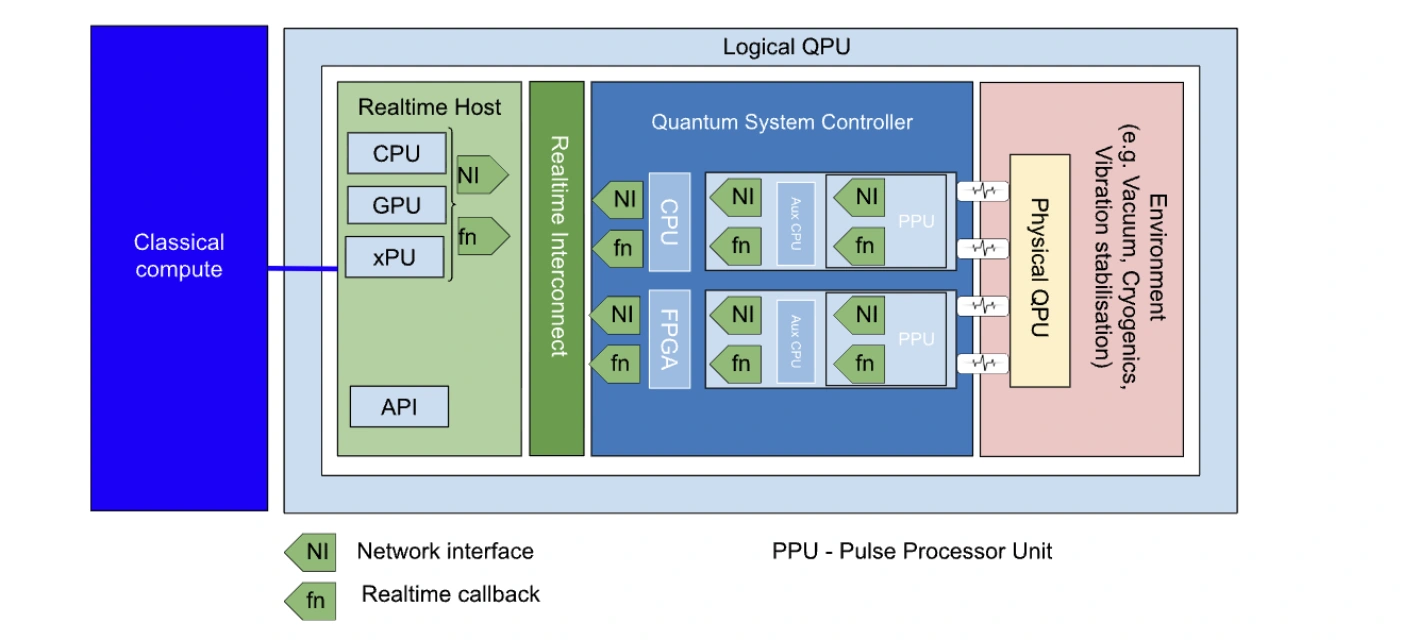
原图:S061,物理第 11 页,Figure 3,HPC and logical QPU schematics。源文将其作为受 NVQLink 启发的参考架构。S061 pp.10–12
这使经典算力拥有三种角色:运行处理器所需的控制资源、异步编译与结果处理的 AI/HPC 资源、执行实时纠错的 FPGA/GPU 等资源池。它们的算力、延迟、可中断性和故障后果不同,资源管理器应分别描述并同时分配。S061 pp.12–17
三条时间轴分别确定互连条件#
应用层混合工作流通常包含经典预处理、量子执行、测量和经典后处理。部分机器学习可用于硬件感知编译、资源分配、shot 后选择及误差缓解,这些任务可相对量子作业异步运行,调度和网络模型接近普通 HPC。S061 pp.14–15
实时纠错则围绕连续的 syndrome extraction 运转。辅助测量揭示错误信息,经典 decoder 根据测量结果更新纠正决策,再把相应动作送回脉冲级执行路径。这里关注的是测量、传输、解码、调度和执行反馈的总时延及抖动;任何一个阶段排队都可能侵占系统可用的反馈窗口。S061 pp.11–17 因此实时路径需要确定的数据量、截止时间、拥塞隔离和超时行为,适合由紧耦合 FPGA/GPU 与控制器协同实现。
第三条是校准、漂移监测和环境控制。它可能在更长时间窗中更新脉冲参数、诊断模型与设备状态,仍会影响实时路径的噪声模型和工作条件。将这三条时间轴分开,可以安排后台计算、批量日志和维护流量,并为实时回路保留稳定资源。
光纤的传播约为 5ns/m,retimer、packet queue 与协议重试还会增加额外时间;这一在 AI scale-up 中的重要关系,同样适合作为量子经典路径的预算方法。S058 pp.55–56,60–61 具体 QPU 的截止时间由设备与控制实现决定,架构应在选定模态后测完整闭环,再决定控制器邻近布局、网络层数和时钟方案。光电链路预算可提供物理路径的通用计算方法。
纠错扩展把经典资源变成核心容量项#
对表面码一类容错架构,物理 qubit 开销近似随 code distance 的平方增长;更低逻辑错误率需要更大的 code distance,逻辑能力增长因而可能引起超线性的物理与经典资源需求。decoder 在正常条件下可近似随每周期稳定子测量数扩展,但更紧截止时间、复杂噪声模型、跨 QPU 同步或并发可能造成利用率陡变。S061 pp.12–13
容量规划需要把“每逻辑 qubit”拆成可计算的资源参数:物理 qubit 数、测量频率、每样本字节数、decoder 每周期工作量、保留窗口和校准附加数据。白皮书给出的一个算例是 1000 个物理 qubit 编码一个逻辑 qubit、每秒采样 1000 次、每样本 4B,得到约 4MB/s,即每逻辑 qubit 每天约 345.6GB 的原始元数据。这个算例采用十进制单位,尚未加入波形、校准和其他日志。S061 p.17
据此,100 个采用同样参数的逻辑 qubit 若完整保留一天,原始数据约 34.56TB。这是对源算例的线性扩展,用于展示保留策略的影响。真实部署应区分实时流、短期诊断环形缓冲、抽样历史及需长期保存的实验记录;压缩、聚合和保留比例需要与可重现的诊断目标一起确定。连续 qubit-hours 比应用输出大小更能反映后台存储负荷。
环境模态决定设施包络#
不同量子模态需要不同的物理条件。中性原子与离子阱依赖激光、真空及精密控制,对温度、湿度、磁场或振动的敏感性随设备而变;超导、退火及部分硅自旋系统依赖 cryocooler 和 dilution refrigerator;光子路线可把光源、纤路与探测器做成机柜设备,探测端仍可能使用低温;diamond NV 同时存在室温和低温实现。S061 pp.25–30,34–39,46–49
| 部署对象 | 设施需要优先闭合的条件 | 对经典平台的影响 |
|---|---|---|
| 激光/真空类 QPU | 温湿度、洁净、光学稳定、真空与激光维护 | 控制电子学、校准、设备邻近布局 |
| 稀释制冷类 QPU | 热排放、冷却水、承重、振动和电磁环境 | cryogenic 设备与控制机柜的空间、供电和运维 |
| 机柜式光子 QPU | 光纤稳定、探测器冷却、机柜交付条件 | 光路时钟、事件读取和经典处理 |
| 室温 NV 类 QPU | 特定设备的微波/光学控制和隔离 | 紧凑节点组合、热与电磁协同 |
S061 的表格以参与厂商配置汇总:如部分低温模态的环境功耗为 15–30kW,室温 NV 示例为 0.3–0.6kW,ORCA photonic 示例为约 3kW;这些是不同设备的环境支撑条件。S061 pp.25–26 它们提示 QPU 本体、电控、制冷和经典 GPU 的功率应分项核算,冷端低温能力与机房热排放也分别表述。
交付环节同样影响落地。离子阱示例包括约 40m² 最小安装区、500kg/m² 承重和 20–24°C 环境;超导示例列出 1000kg/m² 的框架区域承重与具体冷却水条件。白皮书的这些厂商数据用于展示设施差异,选址时需由设备商对振动频谱、磁场、声学、运输通道与温湿度实际勘测。S061 pp.21–24,30,39
从独立接入到紧耦合逐步改变责任#
白皮书区分 standalone、co-located 和 on-node 三种部署:远程独立系统接入较容易,同址减少经典量子交互距离,节点内集成进一步缩短路径并要求更复杂的系统设计。供应商的架构选择决定机柜、制冷、网络与控制布局。S061 p.20
在多租户设施中,还需把 service boundary 写成具体工作项。楼宇与设施运营方提供的电力、水、空间和网络,要对接设备商承担的制冷、真空、激光、校准及控制系统;耗材更换、泵与压缩机维护、停电后恢复和现场介入需要明确责任与验收条件。某些实验室来源设备只有单路电源输入,设施 UPS 与切换策略因此要在设备入口前闭合。S061 pp.20–24,46,50–53
环境隔离也具有双向性:机房内的高功率设备、风机、机械系统可能影响 QPU,QPU 的压缩机、泵、热与电磁排放也会影响周边设备。以一个受控 zone 包围特定 QPU 及其配套设施,可将环境约束与故障影响范围对应起来,再与经典机柜区通过确定接口连接。S061 pp.38–39,51–53
光子设施和遥测可复用为扩展能力#
试点阶段可以把验收拆成一条可连续运行的混合任务:经典端准备输入并提交,QPU 在受控环境执行,控制器持续反馈,结果与校准版本一起进入存储,资源管理器释放或重用设备。并行记录应用完成时间、实时回路截止时间违约、环境偏离、恢复与重校准时长。这样的端到端记录能区分任务排队、经典解码不足、设备校准和设施扰动,也为扩大到更多控制节点或逻辑 qubit 提供容量依据。其观测对象对应白皮书提出的控制面、syndrome、存储、设施和生产运营要求。S061 pp.11–17,50–53
AI Factory 的光纤管理、时钟分发、网络隔离和遥测体系可为量子经典集成提供基础。S056 对机械、电源、信号、热与管理五维接口的组织方法,有助于为异构设备定义明确的交接点;S055 的持久事件、远端状态和时间线则展示了如何让诊断证据跟随组件。S056 pp.74–81 S055 pp.13–15,54,96 复用时应以 QPU 的量测、控制和噪声要求设计专用数据模型,形成从设施到实时运行状态的关联。
量子光网络还有另一层语义。S057 将透明 OCS 作为量子态光路分配的潜在方向;为保持量子态,交换路径需满足损耗、偏振、相位、噪声与波长条件,并与纠缠生成、探测和协议控制配合。S057 pp.29–30 这一物理光路可借鉴光电路交换的资源调度思想,其验收量则需围绕量子链路单独建立。
共享设施也在演进。S061 给出 Maybell 在研的集中 4K plant 向多个模块化毫开尔文节点供给的概念:集中支撑可能改善资源利用,同时把冗余、维护和失效范围提升为共享系统问题。S061 pp.51–53 对技术规划,合适的入口是预留异构扩展区和标准交接条件,待具体 QPU、任务与实时路径明确后,再形成分级容量、设施和运营方案。经典 AI 基础设施由此承接量子系统真正需要的计算与运行能力,并保留核心 GPU 集群独立演进的空间。
