AI Factory 的系统分层与运行闭环
连接计算依赖、OPG/XOC 资源边界和分层控制
从并行计算通信域出发,连接 OPG/XOC 模块、六类网络、网络控制与作业调度,再用 InfraGraph 和状态模型贯通设计与运行反馈。
AI Factory 的系统架构需要把三种关系同时落实:模型执行形成的计算与通信依赖,设备、网络和存储组成的资源边界,以及配置、调度和恢复形成的控制关系。加速器数量提供规模坐标;真正决定系统能否持续交付算力的,是这些关系能否在同一套物理连接与运行对象上闭合。OCP 的集群设计、训练与推理参考架构,以及 Fabric 建模框架,分别给出了这条链上的结构、实施和预测方法。S049 pp. 5–6 S044 pp. 45–55
从计算依赖确定通信域#
Scale-up 的核心作用是把一组加速器组成高带宽、低时延的紧耦合计算域。训练参考架构选择每台服务器八颗 xPU、scale-up 完全位于机箱内部的形态;跨服务器交互进入 scale-out Ethernet。这个形态使机箱成为稳定的设备构件,同时把服务器间的并行通信、租户隔离和网络扩容留给集群层处理。更大规模的机架级 scale-up 系统会改变域内成员和连接方式,资源建模仍然需要保留同样的域边界。S052 pp. 7–9 S048 pp. 14–17
通信域应顺着操作依赖划分。TP 在单层计算内部频繁组合部分结果,通常优先使用紧耦合域;PP 在阶段边界传递 activation,反向传递相应梯度;DP 对各副本的对应参数分片同步梯度;MoE 的 EP 随 token 路由改变目的地。因而“一个集群有多少卡”之后,还需要明确每个并行组怎样跨越服务器和交换层级。配置完全相同的硬件,采用不同的并行组合,可以形成完全不同的链路负载和等待时间。S044 pp. 12–15, 35–37
下面原图适合沿两条路径阅读:先看蓝色 scale-up 怎样封闭在节点内,再看节点伸出的加速器 NIC、CPU NIC 和管理接口分别进入哪些网络。图中 head-end 连接存储与管理路径,说明作业入口、数据准备和系统恢复本来就是完整集群的组成部分。
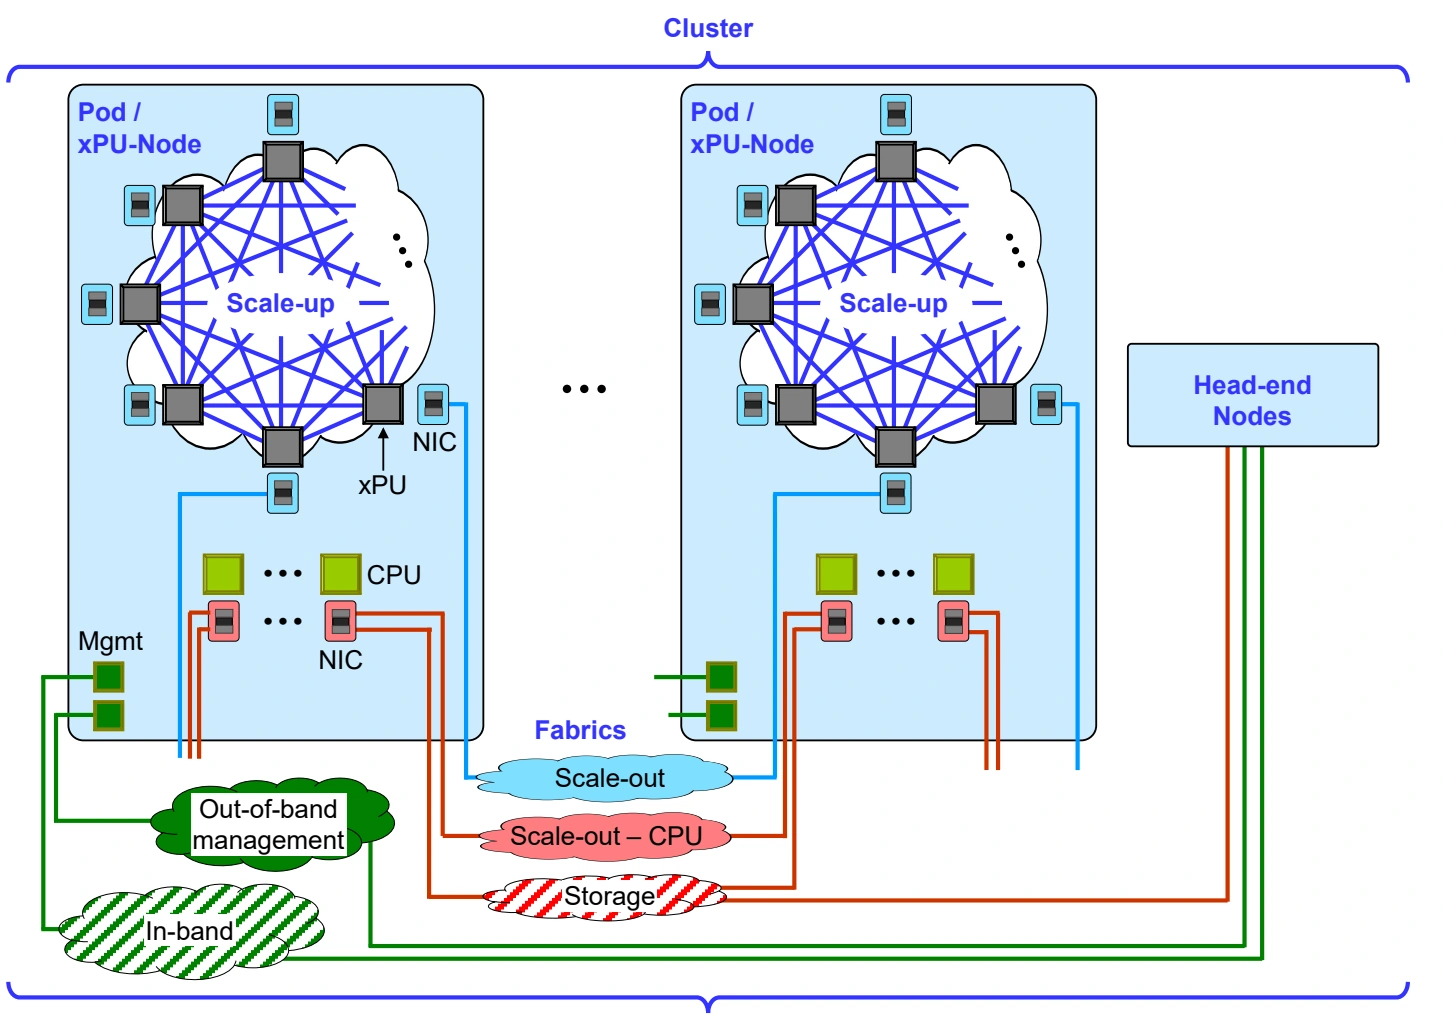
原图:S052,物理第7页,Figure 1,Lowell D. Lamb 等/OCP,CC BY-SA 4.0。
用模块包含关系连接采购与运行#
OPG-M 把 M 颗 xPU 与配套 leaf、存储、管理连接和机架资源组合为扩展单元。XOC-N 在一个或多个 OPG 之上增加 spine、聚合网络和 head-end,形成共享 scale-out 域的完整集群。这个包含关系使计算模块可以复用,又允许共享层按整集群的业务需求独立配置。OPG-128 的早期实例包含十六台八 xPU 节点,XOC-1k 由八个这样的模块组成,共计 1,024 颗 xPU。S052 pp. 6–10 S050 pp. 6–8
模块的工程价值来自接口足够具体。完整设计应列出设备类型、数量、NIC、线缆、光模块、端口映射、软件组件,以及空间与电冷条件。逻辑上等价的拓扑有多种接线方法,实际采购、布线和故障定位需要选定其中一种,并让管理系统使用同一组设备身份和端口坐标。训练 RA 进一步把这些连接表达为 Wiring API 的 Switch、Server 和 Connection 对象,使接线表成为可校验的配置输入。S049 pp. 13–18 S048 pp. 48–49, 74–75
例如,十六台服务器的计算模块增加一倍后,计算卡和服务器 NIC 可以直接按模块数量推算,共享 spine 则要重新检查端口占用。XOC-1k 的早期设计已把 scale-out 和 SO-C spine 端口用满;继续扩容需要增加交换资源并重映射连接。模块化在这里保留了计算单元的稳定性,共享层扩展仍由端口预算约束。S050 pp. 55–57 具体预算见从 Pod 组到开放集群。
将六类网络映射成明确的运行责任#
早期开放集群以六类逻辑网络说明系统分工。Scale-up 连接紧耦合加速器;scale-out 连接不同节点的 xPU;SO-C 承载 CPU 间生产通信;storage 交换数据集、模型和检查点;in-band 为操作系统层的部署、调度、遥测和更新提供路径;OoB 直达 BMC、交换机管理口和 PDU,使主操作系统或生产网络受损时仍可控制硬件。S052 pp. 7–12, 34–44
这些角色可以按负载融合。训练 RA 的 Minimal 保留后端 scale-out,将 SO-C 与 storage 融合,再加带内和带外管理;Full 将 SO-C 与 storage 分开。推理 RA 的 Minimal Inference 进一步省去后端网络,适用于模型和关键数据依赖都停留在单个 xPU-node 的服务;Distributed Inference 在存在跨主机模型切分、分离执行或共享缓存依赖时加入 RDMA 后端。选择过程因此落在通信依赖和资源竞争上,网络数量随系统形态确定。S048 pp. 28, 45 S047 pp. 21–24, 40–41
例如,把模型服务与训练作业共置到一个硬件池,前端与存储融合可减少独立设备,但模型加载和检查点突发会竞争相同上行;把推理拆成 prefill 和 decode 两池后,又会新增 KV 迁移。规划应逐项列出对象、发生阶段、目的地和时限,再决定物理隔离、队列隔离或共享容量。对这类流量的进一步拆解见并行策略塑造通信关键路径和推理解耦与 KV 数据路径。
分开描述网络控制、资源调度与任务执行#
训练和推理 RA 使用 Kubernetes 中的控制器持续比较网络期望状态与实际状态,经每台交换机上的 agent 配置 SONiC。Wiring API 描述设备和连接;VPC API 描述租户 VRF、子网 VNI、附着及外部连接。由此,物理连线与租户连接可以分别审查、版本化和回滚。控制器暂时失联时,交换机继续使用最后应用的配置转发,后续配置协调待控制器恢复后继续。S048 pp. 26–28, 48–51 S047 p. 20
集群调度则处理资源分配:哪个作业获得哪些节点,怎样满足拓扑局部性、内存容量和租户公平性。工作负载执行引擎进一步安排操作次序,包括 micro-batch 的推进、collective 的启动和数据预取。三个层次需要交换约束,却各有状态和动作范围。网络控制器知道真实端口连接,调度器知道分配关系,运行时知道计算依赖;让这三类信息可关联,才能解释一次作业延迟究竟来自错误放置、拥塞还是阶段不平衡。S044 pp. 16, 52–55
这种分工也体现在 head-end。XOC 设计为 scheduler、monitoring、系统镜像、容器仓库、代码仓库、CI/CD 和 staging 分配专门角色;关键管理服务通常至少两个实例,容器仓库示例采用三个实例。管理服务有自己的计算、存储和网络开销,扩容计划需要将其随作业数、镜像分发量和遥测量增长的部分单列出来。S050 pp. 10–14
将系统就绪定义为一组相互依赖的条件#
从设备到作业,需要依次经过硬件可管理、网络连通、数据可取得、运行环境可分发、调度可分配和计算可执行。XOC的head-end设计已经为这些条件分配具体服务:带外服务控制硬件,镜像构建与仓库准备操作系统,容器构建与仓库提供框架环境,scheduler分配资源,monitoring收集运行状态。这些角色各有连接速率、存储源和可用性要求,系统就绪判断应能逐项落到具体对象。S050 pp. 11–14
例如,一台替换后的计算节点能够被BMC访问,还要完成镜像部署、驱动与框架准备、GPU/NIC身份识别、租户网络附着和数据路径检查,才适合重新进入作业池。网络RA的替换流程恢复交换设备身份与配置,系统软件流程恢复主机环境,调度器在验收后重新接纳节点。本文将这些原有角色串成一条恢复链,便于技术评审识别缺失的交接条件。S048 pp. 47–51 S050 pp. 11–14
同样,一套系统可以在设备层完全健康,却因镜像仓库分发、存储元数据或状态回迁排队而推迟作业启动。只记录加速器利用率会把这些等待汇成一个模糊的空闲比例。将启动时间拆到镜像、连接、数据和计算准备阶段,再结合设备与端口遥测,可以区分需要增加共享服务容量、调整放置,还是修复具体节点。AFPM的数据服务与编排分工、RA的可观测性接口为这类关联提供了基础。S044 pp. 16, 37–44 S048 pp. 50–54
系统接口还应保留版本。服务器内部scale-up形态、NIC端口模式、交换机profile和运行环境会一起影响可用的组合。网络RA用switch profile表达端口布局、速率、FEC和breakout,用版本化CRD保存连接与overlay意图;XOC的镜像、容器和代码仓库管理软件资产。把一次作业绑定到这些配置版本,性能回归与恢复验证才能使用同一组条件。S048 pp. 47–50 S050 pp. 12–14
用同一张系统图连接设计与反馈#
InfraGraph 将设备建模为可嵌套子图,内部组件包括 GPU、CPU、NIC 和内存;link 定义连接类型,edge 绑定具体设备端点。相同图上可附带带宽、时延、功率和可靠性属性。工作负载则通过计算、内存访问、collective 及依赖组成 DAG。二者输入映射决策引擎,才有条件估算作业放置、交换机维护或链路故障对完成时间的影响。S044 pp. 45–54
Agent 工作流使模型继续扩展到动态状态:MemoryTierNode 记录 KV 所在层级,session affinity 连接会话与状态位置,AgentTaskGraph 记录后续步骤与上下文增长,JournalNode 记录持久写性能。这样,同一批 GPU 的可用性便同时受计算空闲量、状态回迁时间和日志提交能力影响。相关运行路径见Agent 状态与因果恢复。这些是 S045 提出的模型扩展,实施时需要把实际运行信号接入调度与恢复流程。S045 pp. 29–30
系统图最终还要接到设施接口和运营责任。Google 0.5.0 设计流程要求把 ML、网络、辅助计算存储和维护空间一起迭代;多厂商 0.7.0 进一步采用模块化线密度和共同设施接口。Open Data Center for AI 则把 SLA、遥测和功率估算列为协同行动线,要求设施业主、IT 业主和负载运行者对指标与动作形成共同约定。对技术规划而言,一套成熟的架构应能够从业务操作追到通信路径,从通信路径追到设备端口,再从运行事件追到负责采取动作的控制系统。S046 pp. 24–25 S053 pp. 7–9 S051 pp. 7–10
