时间同步与跨域测量
PTP、GPU到PHC校准、误差预算与时钟资格验证
区分物理时间、单调时间与因果关系,沿PTP分发、事件打点和GPU/CPU/NIC校准链构建可验证的时间基础设施。
跨主机时间首先是一项测量基础设施。一个训练step变慢,需要区分某张GPU迟到、NIC排队还是链路延迟;一次解耦推理请求需要将网关、prefill、KV传输和decode的耗时拼成同一条时间线。共享时间基准让这些事件能够比较,准确的事件捕获与跨时钟域校准则决定比较结果能分辨多短的延迟。S101 pp. 4–11
OCP的AI授时白皮书将系统分成时间分发、事件打点和时序可观测三平面;测试指南进一步给出Time Receiver、Boundary Clock和Transparent Clock的误差测试方法。将架构和测量放在一起,技术规划可以从业务需要的归因精度推导设备及网络指标,再验证整条链在负载、温变和故障切换下的表现。S101 pp. 17–19, 22–23 S100 pp. 6–10
三种时间问题对应三种机制#
分布式系统同时需要时间位置、经过时长和因果关系。可比较的物理时间用于跨机定位事件;本地单调时钟测量elapsed time;trace/span关系、逻辑进度和版本用于确定因果与一致性。这些信息可以在一条记录里共存。S101 pp. 8, 10–16
例如,一次checkpoint由共同step或epoch、快照语义及元数据原子提交保证一致;共享物理时间可以调度启动时刻,并观察各分片何时开始和结束。Collective依赖匹配的调用、rank、stream和操作顺序,跨机时间线则帮助发现哪个参与者迟到。Agent工具链中的trace关系建立父子调用,时间戳补上并行分支的持续时间及等待。S101 pp. 10–16, 20
因此,授时目标应从某项功能需要分辨的事件出发。若只需人工对齐秒级告警,与分析几十微秒的单向网络延迟,所需误差预算显著不同。选择更高精度需要硬件、布线校准、时钟监控和测试成本;合理目标是让残余误差足够小,以支撑对应的工程判断。S101 pp. 22–26
PTP用四个时间戳估计偏移与传播时延#
在基本delay request-response交换中,发送端在t1发送Sync,接收端在t2接收;接收端在t3发送Delay Request,发送端在t4接收。假定两个方向传播时延相等,且已按机制处理驻留时间,可估计:
其中是接收时钟相对发送时钟的偏移,是平均单向时延。若前向与反向真实时延分别为与,偏移估计中的非对称误差为。这个由交换模型直接得到的关系解释了为何链路非对称校准属于精确授时的一部分。S101 pp. 6–7
Boundary Clock(BC)终结上游PTP,在上游作为Time Receiver,校准内部时钟,再向下游作为Time Transmitter重新分发。Transparent Clock(TC)转发PTP事件报文,测量设备内residence time并累加到correctionField。两者分别通过时钟重建和驻留补偿处理多跳路径,器件误差、路径非对称和伺服行为仍需测量。S100 pp. 7–9 S101 pp. 18–19
选择PTP profile时要同时确定传输方式、delay机制、domain、消息间隔和拓扑。S101给出的BC层级是架构示意;其引用的OCP Data Center PTP Profile v1.1采用TC链、IPv6和end-to-end delay机制。项目应以一套一致的profile作为设计与测试契约,再决定设备角色。S101 p. 19
NIC同步后还要校准GPU与CPU时间域#
读下面的原图时,从参考时间沿NIC PHC、CPU和GPU之间的校准连接向下追踪。图中每条连接都是独立的误差来源:网络授时建立共同基准,host到PHC的cross timestamp完成主机映射,GPU活动记录再映射到CPU时间域。
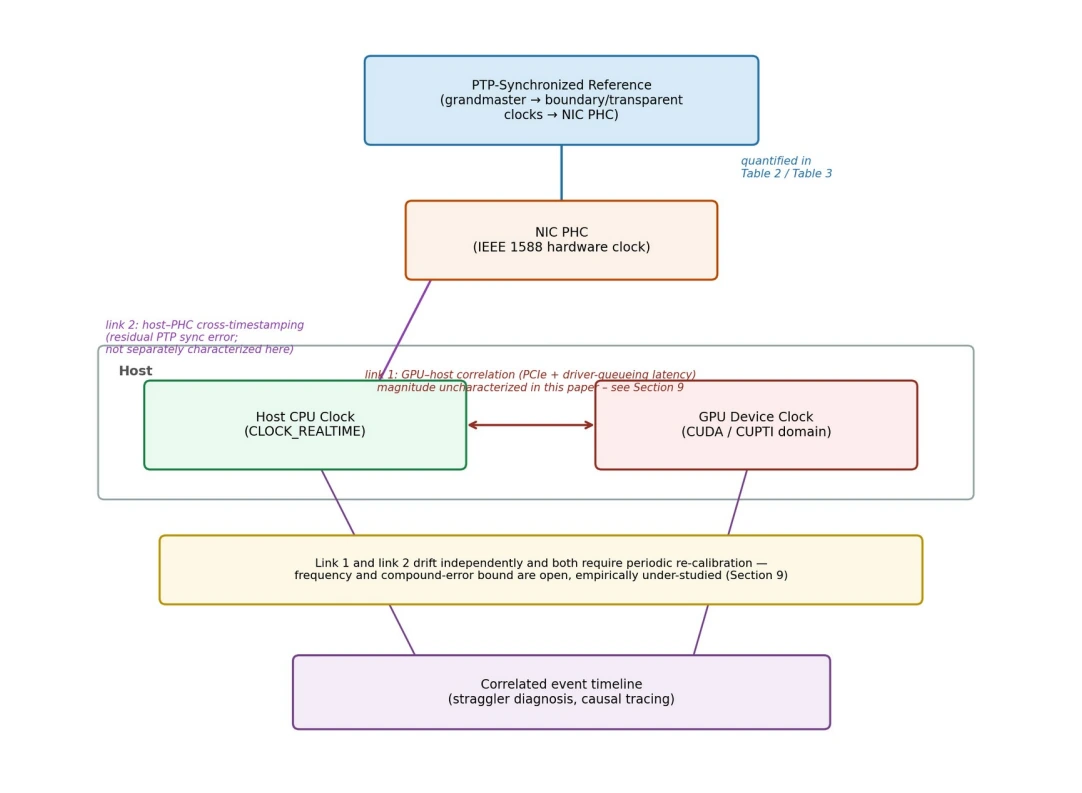
原图:Time Synchronization in AI Distributed Infrastructure 0.9.1,Figure 2,物理第10页。S101 pp. 8–10
支持相应功能的NIC通过PHC暴露硬件时钟;主机可利用PTP_SYS_OFFSET系列接口建立PHC与CLOCK_REALTIME的对应。GPU活动时间来自独立设备时钟域,文中以CUPTI为例说明其活动时间经插值转为CPU时间。两条映射会各自漂移,需要在实际设备、驱动、记录类型和负载下确定重校周期及误差界。S101 pp. 8–10, 24
事件本身的捕获位置同样关键。MAC或PHY硬件时间戳、内核打点和应用日志,分别包含不同的队列、调度和软件路径。报告“网络延迟”时应明确测量边界:线上序列化、交换机驻留、NIC到NIC与应用可见RDMA完成时间,代表不同量。S101 pp. 6–9, 22–23
以本文演算为例:要分辨10 μs的跨机阶段差异,团队允许最多10%的归因误差,则先得到1 μs的测量目标。这个目标要在两端时钟偏移、打点抖动和校准残差之间分配,并以实际分布验证。追踪记录的序列化、发送及分析开销另外进入吞吐与资源预算;它不天然等于时间戳误差。S101对这几类误差作了明确区分。S101 pp. 22–23
五类试验刻画稳定态与失效过程#
授时设备验收可以按噪声产生、噪声容限、噪声传递、暂态响应和holdover五项组织。噪声产生测量理想输入下设备自己引入多少误差;容限试验逐步向输入加入扰动,观察告警、参考切换或进入holdover;传递试验测输入噪声如何被滤波或传向下游。S100 pp. 6, 14–24
下面的BC测试接线把上游PTP、下游PTP、1PPS与频率输出放在同一分析参考下。读图时注意测量同时覆盖“时钟接收得准不准”和“再分发输出准不准”,两者共同影响下游误差预算。
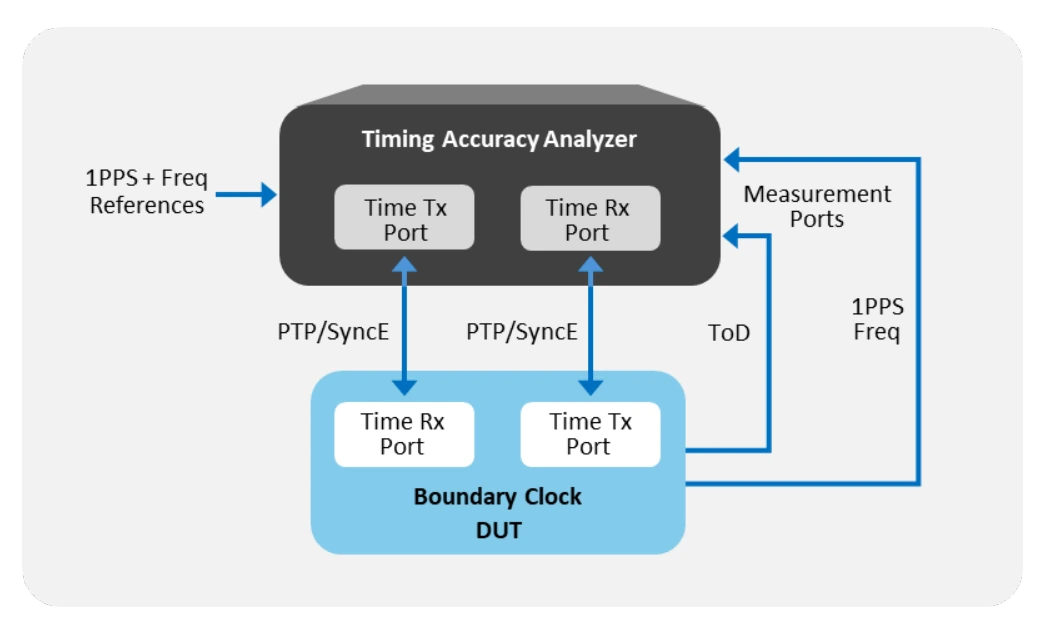
原图:Time Error Measurement Test Guide,Figure 2,物理第12页。S100 pp. 10–13
Time Error定义为被测时间减参考时间。平均偏移形成cTE,变化部分形成dTE;cTE常与路径或打点非对称相关,dTE常与PDV和捕获变化相关。设备是否适用需要同时看最大绝对TE、均值和不同观察间隔上的动态表现。只报告平均偏移,可能隐藏瞬时峰值和温变漂移。S100 pp. 9, 14–19
指南引用G.8273.2的BC/Time Receiver等级供试验设计使用:A、B、C未滤波最大绝对TE分别为100、70、30 ns,cTE范围分别为±50、±20、±10 ns;D的5 ns是经0.1 Hz一阶低通后的最大绝对TEL。滤波方法和统计量不同,不能把D的数值与前三者简单排成一个“精度排行榜”。具体AI链路目标由项目预算决定。S100 pp. 15–17
恒温噪声测试建议运行1000 s,考虑温变时延长到10000 s,并观察MTIE、TDEV等随观察间隔变化的量。TC试验则比较实际驻留时间与correctionField记录,检查补偿误差。测试报告需记录profile、接口速率、包率、温度、参考与滤波方法,保证器件和整链结果可比较。S100 pp. 14–19
从最短目标事件反推整链测量方案#
确定测量边界后,可以先建立两台主机的基准试验:在选定NIC打点处发送可识别探针,同时记录主机、PHC和GPU活动时间域的映射。将同一批事件分别以原始域和统一域展示,观察跨域转换前后的顺序与间隔变化;再增加GPU负载、CPU调度压力和网络竞争,检查残余误差是否随负载改变。这是本文依据三平面架构提出的项目验证方案。S101 pp. 8–10, 17–19, 22–24
扩展到多跳时,每一跳保留真实BC或TC角色、profile配置和链路条件。BC的内部振荡器与伺服会改变噪声传递,TC则要测实际驻留与补偿字段之差;整条链的误差通过独立参考验证。即使各器件分别合格,路径非对称、参考切换或配置混用仍会改变最终结果,所以器件资格和系统测试应分别保留。S100 pp. 11–23, 28
测量采样也要匹配问题尺度。秒级利用率适合容量趋势,微秒级等待需要更细的事件记录,但持续全量采集会增加记录量和处理成本。团队可以先用低开销指标定位异常窗口,再提高该窗口内的采样和跨设备关联深度,所有记录保留打点位置与校准状态。目标是捕获足以解释一次异常的事件链,并验证采集本身对工作负载的影响。S101 pp. 12–13, 22–24
分析器还应处理时间区间的重叠。如果两事件的时间差落在当前校准误差内,物理时间无法单独判定先后;trace父子关系和逻辑顺序仍可帮助还原因果。将这种情况保存为测量分辨能力的结果,可以防止自动根因系统把微小偏移解释成网络排队或计算迟到。S101 pp. 8, 15–16, 22–23
将失锁、主钟切换与安全纳入运营#
Holdover试验移除PTP或频率输入,观察设备使用本地振荡器维持时间的持续能力;暂态试验改变参考或网络路径,测量失锁、重新锁定和期间时间跳变。双grandmaster只有在上游参考和故障域也独立时,才提供相应来源冗余。运行系统应保存当前参考、锁定状态、holdover持续时间、最大误差与校准新鲜度。S100 pp. 24–27 S101 pp. 17–18
时间分发也有信任问题:GNSS干扰或欺骗、错误主钟选举、路径选择性延迟都能改变观测时间。保护措施需要覆盖来源健康监测、主钟认证与密钥管理、独立路径比对及异常holdover策略;真实报文被恶意延迟时,报文认证本身仍需辅以路径监控。S101 pp. 24–25
在未来平台建设中,可以把时间质量作为遥测的伴随字段:记录事件时刻、打点位置、时钟域、校准版本与当前不确定范围。训练拓扑性能分析、推理解耦和可靠性处置由此共享可比较的证据;当授时退化时,分析器也能识别哪些延迟判断仍可信、哪些需要重新测量。
