训练 Fabric 的流量控制与运行闭环
联结容量、PFC/ECN、端点调优、声明式配置与验证
解释训练通信从 GPU/NIC 到交换队列的完整路径,区分流量分类、拥塞反馈和路径分配,并用 Day0/1/2、双平面维护和分层验证落实运行能力。
训练 Fabric 的性能来自一条完整链路:并行组产生通信,NIC 选择真实数据路径,交换机分配队列与上行,端点根据拥塞反馈调整发送,调度器再利用拓扑局部性减少共享层压力。线速带宽规定容量上限,实际训练时长由这条链上暴露在计算依赖中的等待共同决定。开放集群设计提供可复算的拓扑,训练 RA 将其落实为配置、策略和生命周期流程,AFPM 则给出跨计算与网络的建模框架。S052 pp. 26–39 S048 pp. 19–28, 43–55 S044 pp. 35–55
先闭合拓扑容量,再观察实际流量#
训练 RA 以DS5000的64×800G端口为基线,半数接服务器、半数接spine。服务器侧拆成64×400G后,能够承接八台各有八个400G NIC的节点;上行则提供相同的25.6Tb/s。XOC-512示例为八leaf、四spine,XOC-1024为十六leaf、八spine。网络容量随计算规模扩展,leaf上下行保持相同总速率。S048 pp. 20–22
这些容量约束与rail分配是两个设计轴。单归属接线把一台服务器全部八NIC放到共同leaf,八节点域内所有后端流量局部转发;rail接线把相同GPU/NIC亲和索引分到共同leaf,在更大的服务器集合内保留同rail局部性。前者适合充分利用域内跨rail交互,后者适合集中同rail流。相同交换容量下,二者差异体现为哪些通信使用spine。S048 pp. 22–25, 29–37
早期OPG/XOC设计给出另一种具体设备组合:OPG-128的rail实现使用四台25.6T leaf,单归属实现用两台51.2T leaf;XOC-1k两者都用八台51.2T spine。采购时应保留这组设备容量条件,再计算每对leaf—spine的链路数。拓扑和超售算式详见从Pod组到开放集群。S052 pp. 27–33 S050 pp. 22–33
队列、拥塞信号与路径分配分别处理不同问题#
RoCE-oriented QoS首先让主机通过DSCP选择RDMA流量类,并使交换机沿路径采用一致的分类。训练RA的开关统一配置RDMA队列、PFC阈值、ECN标记以及ECMP相关行为。推理RA附录进一步给出同一平台的类别示例:TC0为普通流量,TC3为带PFC和ECN的RoCE流量,TC6保护控制通信。这样的分类可作为理解实现的坐标,实际DSCP数值与映射应由部署配置明确。S048 pp. 45–46 S047 pp. 57–58
PFC在链路上对指定优先级施加暂停,处理瞬时buffer压力;ECN把拥塞状态标记给端点,由相应拥塞控制调整发送。二者的反馈范围不同,配置需要与NIC实现和流量突发共同校核。AFPM将PFC、ECN/DCQCN列为RoCE设计的重要组成;训练RA把这些参数集中到声明式模型,目标是让队列映射与阈值跨设备一致。S044 pp. 29, 32–34 S048 pp. 45–46
ECMP解决可用路径之间的分配问题。AI流量可能包含低熵、长持续时间的大流,少数路径碰撞会使其他链路仍有余量时出现局部排队。训练RA采用QPN-aware hashing增加RDMA流的散列信息;AFPM还讨论adaptive routing、flowlet与packet spraying。选择更细粒度的路径分配时,端点对乱序的支持和恢复行为需要一起评估,才能将路径利用率改善转为有效通信吞吐。S048 pp. 45–46 S044 p. 34
把主机内部路径纳入传输调优#
rail的物理基础是GPU到NIC的PCIe亲和性。每个GPU通常具有到某个NIC较短的内部路径,集合通信库需要正确识别这个关系。跨错NIC会改变PCIe交换、CPU互联或内存路径的负载,单看交换机端口利用率可能看不出源头。因此,训练RA把NIC固件、中断亲和、内存注册和内核参数列为端到端性能的重要因素。S048 pp. 30, 46
一次训练调优可以按数据路径逐段推进:先确认GPU/NIC索引和端口映射,再核验DSCP是否进入预期队列,随后比较同rail、跨rail和跨域collective的吞吐与尾时延,最后观察训练step暴露的通信等待。这样,某个host配置变更带来的收益可以在相同拓扑和放置条件下检查,网络参数变更也可以保持相同主机状态进行对照。RA将NCCL/RCCL类流量、端口映射与失败演练一起纳入验证方法。S048 pp. 46, 52–55
存储流量也需要进入观测。输入预取、embedding lookup、checkpoint写入和恢复读取具有不同依赖;其中有些可以与计算重叠,有些直接阻塞下一步。SO-C/storage融合时,共享链路要同时满足CPU生产流和I/O突发;Full配置将两者分开,使资源竞争更容易分配和定位。S044 pp. 37–44 S048 pp. 28, 45
将同步突发变成可复现的负载场景#
集体通信可能在很多发送者同时到达阶段边界时形成突发。AFPM特别指出All-Reduce、All-to-All与不同执行阶段的流量变化会造成incast和排队,因此平均链路利用率应结合时间分布观察。某条链路的分钟平均负载较低,仍可能在每个训练step的短窗口中成为关键路径。测试时保留消息大小、并发参与者与启动关系,才能复现这种瞬时压力。S044 pp. 33–34
本文可以据此构造三组场景。第一组保持同rail归约,分别放在共同rail域和跨域位置,验证spine流量变化;第二组增加跨rail交换,观察单归属域与rail域对上行的不同需求;第三组叠加checkpoint或模型数据读取,检查I/O突发对通信尾部的影响。三组场景的计算、固件与传输参数保持一致,变化项对应一个明确的机制假设。S048 pp. 23–25, 52–55 S044 pp. 41–44
遥测需要关联三个时间尺度。交换端口和队列提供拥塞位置,NIC与collective记录提供通信耗时,训练step或作业完成时间提供业务影响。若PFC事件增加而作业时间没有变化,可能有足够计算重叠;若某个DP归约尾部延长,更新步骤就可能暴露等待。把事件时间戳与并行阶段对齐,比单看累计计数更容易解释优化是否进入了关键路径。S047 pp. 58–59 S044 pp. 35–37, 43–44
故障演练也应覆盖相同负载。空载时链路切换可用,满载下还要观察剩余路径容量、重分布和尾部恢复;维护一台spine或一个plane,会同时改变可用路径和共享带宽。RA要求在失败与维护场景验证连续性、协调和可观测性,操作方可以把退化容量下的作业完成目标加入验收,形成可执行的维护窗口。S048 pp. 39–43, 51–55
用声明式状态维护整条配置链#
Wiring API中的Switch、Server和Connection描述物理角色及连接,VPC API描述VRF、VNI、附着和外部路由。控制器根据这些对象计算期望状态,交换机agent将配置写入SONiC。EVPN分发overlay路由,VXLAN承载数据;在DS5000所用TH5与Broadcom Enterprise SONiC配置中,overlay使用L3VNI。S048 pp. 27–28, 43–45
下面原图要沿两组箭头阅读:控制器与交换机agent同步配置,agent经gNMI影响Config DB及ASIC;Alloy与Fabric Proxy把日志指标送到LGTM。前一组决定网络应如何转发,后一组提供实际运行反馈。
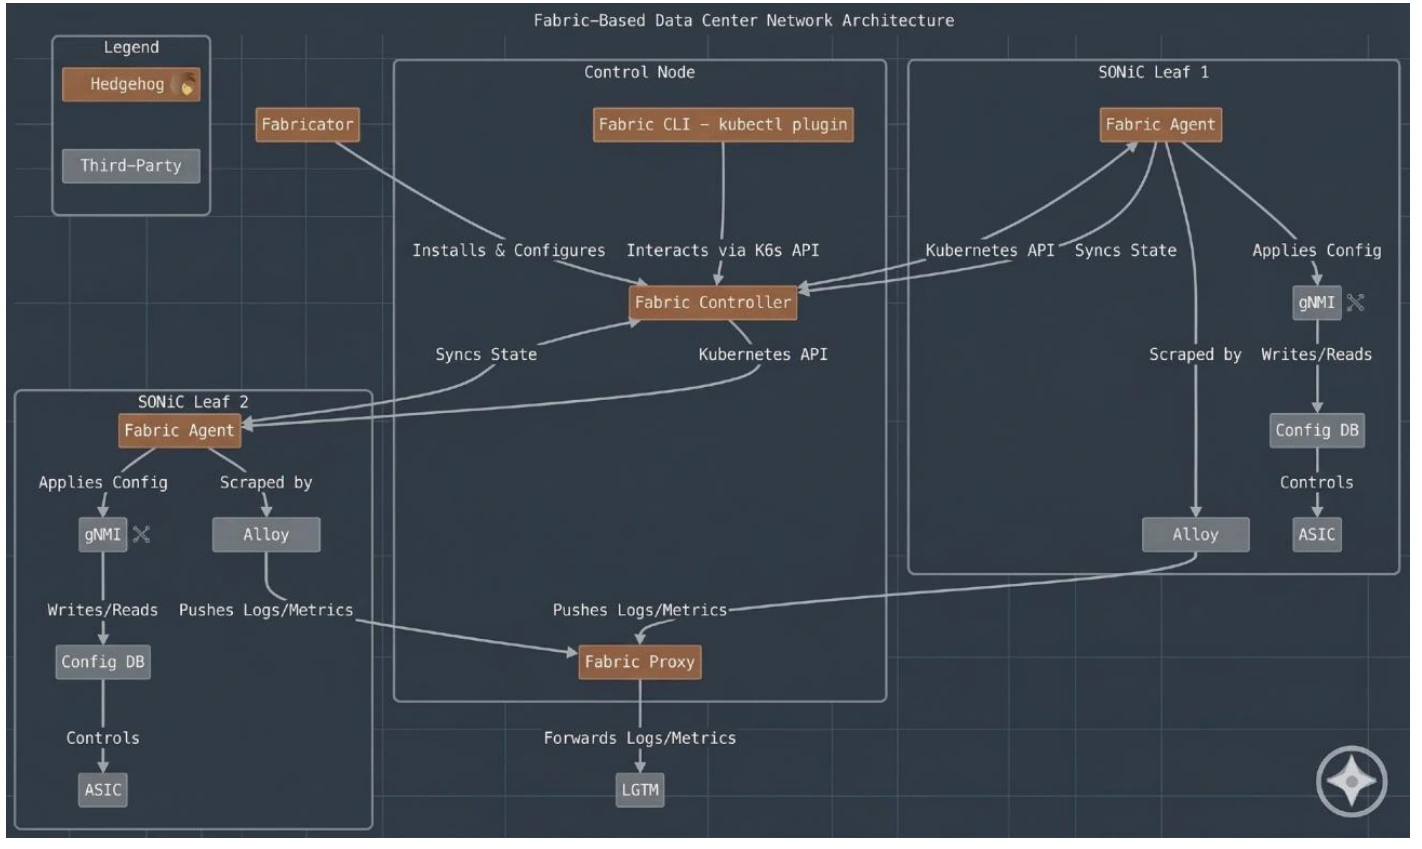
原图:S048,物理第26页,Figure 2,Art Fewell、Arun Solleti/OCP,CC BY-SA 4.0。
OoB独立部署,承担BMC和硬件恢复。RA让其不受Hedgehog管理,避免恢复通道依赖被恢复的fabric。网络控制器失联时,交换机沿用最后应用的SONiC配置继续转发;硬件故障则需要按实际拓扑隔离或替换。这种分工让控制服务维护、交换机更换和生产数据传输可以分别设计故障流程。S048 pp. 16, 19, 40, 50–51
生命周期操作也要消耗性能预算#
Day0通过ONIE和DHCP完成发现、镜像安装、身份与平台profile绑定,profile保留端口、breakout、speed/FEC及RoCE能力。Day1应用Wiring/VPC意图,经过schema、准入与端点检查,再核验实际接线。Day2持续比较期望状态与设备状态,以最小delta修正漂移;替换设备时重新关联原身份和profile,恢复其逻辑配置。S048 pp. 47–51
双平面把维护拆到Plane A、Plane B,但每停一平面,聚合带宽约减半。2×200G配置每NIC平时合计400G,停一侧剩200G;2×400G平时800G,停一侧剩400G。作业能继续推进的条件包括集合通信库正确使用剩余平面、流量可重新分布,以及业务接受退化后的性能。RA据此要求按平面逐步验证,并为超过剩余容量的负载安排维护策略。S048 pp. 31–43, 51–52
配置变更应与流量分组一起安排。改变breakout、NIC速率或端口角色,会影响Wiring端点;改变VRF、VNI或peering,影响逻辑可达性;改变DSCP映射和RoCE参数,影响队列行为。RA的准入检查、canary、顺序更新和回滚可以分别覆盖这些对象。运行记录保留变更前后意图、设备实际状态及流量测量,就能把一次性能变化追到具体版本。S048 pp. 47–51
多OPG集群还可以按leaf组逐步升级:先处理一个OPG,确认连通、路由、队列和作业健康,再进入下一组。双平面则以plane为额外分组。两种分组都需要将已有作业、剩余带宽和故障恢复约束放入维护计划;一组设备升级成功后,才扩大相同变更的覆盖范围。这使声明式配置与运行容量形成实际的操作闭环。S048 pp. 49–52
用三层证据校准系统结果#
第一层是逻辑正确性:connectivity-map覆盖端点,BoM与标签一致,VRF隔离和外部路由符合意图。第二层是运行行为:ZTP、配置漂移、controller/agent重启、链路故障与滚动升级都能按预期恢复。第三层才是实际负载性能:比较放置对齐前后的spine利用率、collective尾时延和训练完成时间。S048 pp. 52–55
RA引用FarmGPU的XOC-512 B200现场部署与外部分析作为经验来源,自己的验证章节还明确区分实验室流程与规模外推。VLAB用于配置、协调和故障演练,物理NIC、交换buffer及链路的性能通过硬件负载测量确认。这样的证据结构能让新部署既复用已有工程经验,又为自己的模型、流量和故障条件建立测量基线。S048 pp. 53–55
进一步把这些遥测映射回硬件图和workload DAG,就能比较增加上行、改变rail域、调整并行组或维护某台spine的影响。AFPM提出在线数字孪生支持这种预测,实际落地可从受控场景和逐步校准开始。与调度相关的建模过程见拓扑放置与性能建模,计算依赖见并行策略塑造通信关键路径。S044 pp. 45–55
